Conectarea furnizorilor terți și self-hosted
Libre WebUI 0.16.0 adaugă Provider connections în Settings > Plugins. Activați un furnizor inclus, indicați alt API unui plugin compatibil, inspectați catalogul efectiv sau conectați un gateway propriu într-o rețea de încredere.
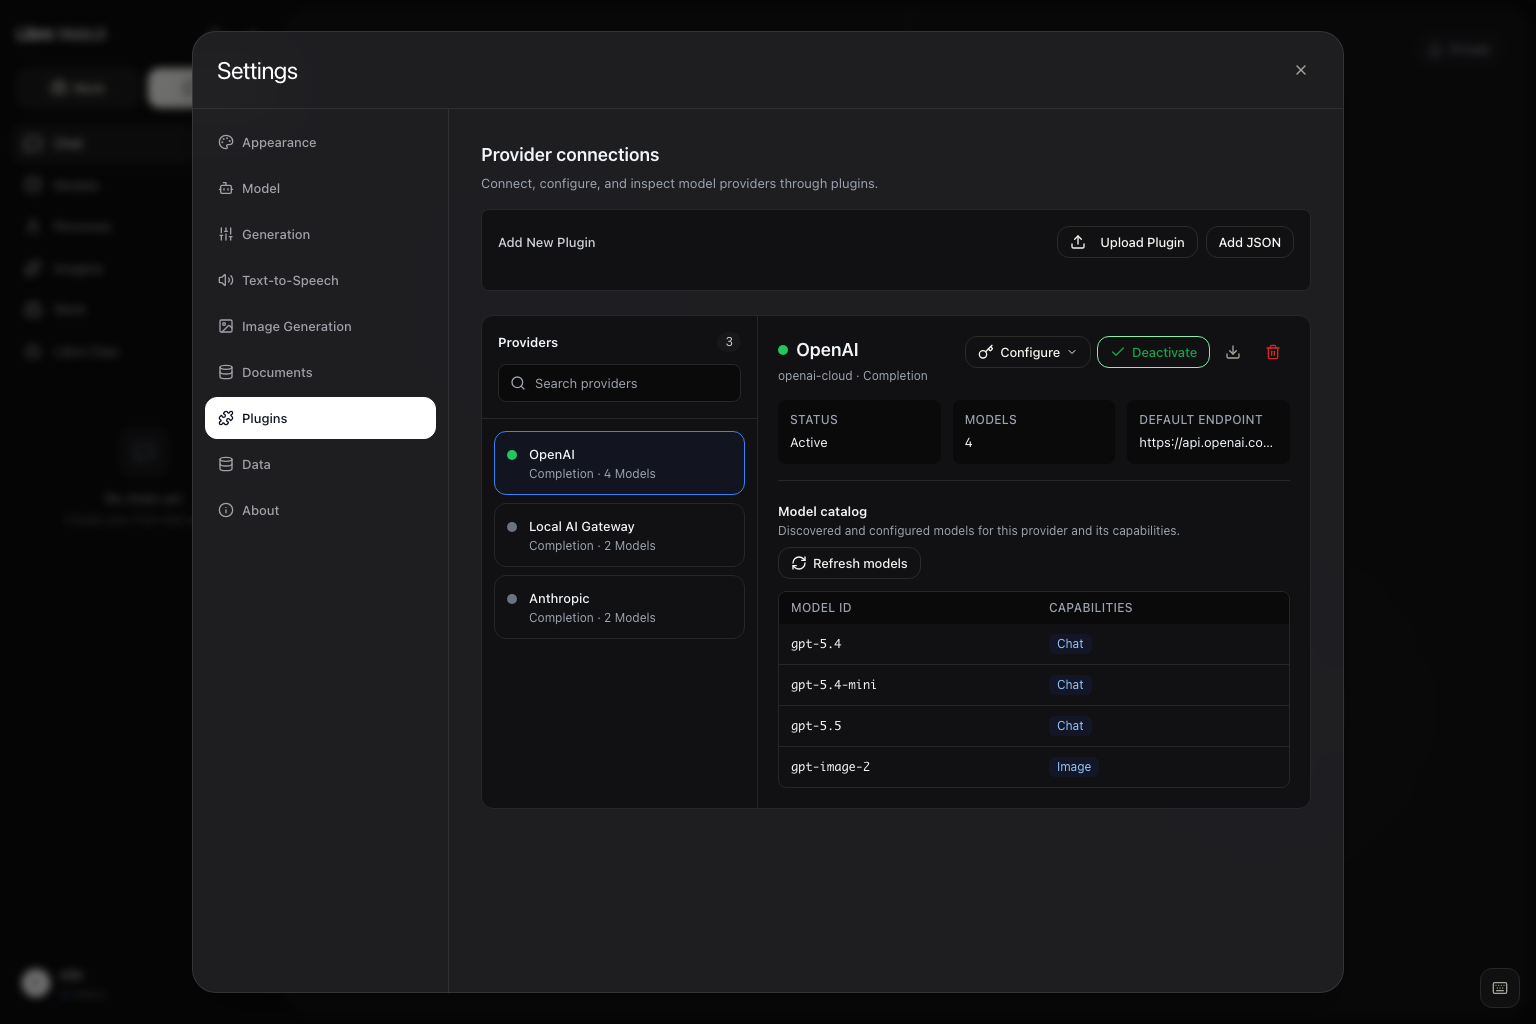
Formate suportate:
- OpenAI Chat Completions;
- OpenAI Responses;
- Anthropic Messages; și
- Google Gemini contents și function calling.
Definițiile Anthropic/Gemini folosesc adaptoare dedicate după identitate. Un import nou folosește semantica OpenAI Chat Completions sau Responses; un URL compatibil Anthropic nu selectează adaptorul. Alt request/stream/tool/response shape cere adaptor backend. JSON descrie routing/config, nu traduce protocol neînrudit.
Deschiderea Provider connections
- Autentificați-vă și deschideți Settings > Plugins.
- Căutați furnizorul în stânga și selectați pentru stare/catalog.
- Activați pentru cont.
- Folosiți Configure numai pentru credentiale sau override.
Configurația este închisă implicit. Adminii văd întâi conexiunea, iar sampling precum temperature/token limits în Advanced parameters separat. Valorile moștenite apar ca hint, nu override precompletat.
Definițiile sunt comune instanței, deci import/install/update/delete doar admins. Fiecare utilizator controlează activarea, credentialele și generarea permisă.
Conexiune rapidă
Settings > Connections este calea scurtă: un endpoint compatibil OpenAI și o cheie. Adminul vede runtime Ollama local cu health/version, lista și formular.
Sunt necesare nume, URL complet Chat Completions și cheie opțională. Libre derivă ID, instalează definiția, salvează cheia server-side, activează și întreabă endpointul. Modelele găsite înlocuiesc placeholder catalog și apar în Chat.
Fiecare rând are endpoint, count, stare key, toggle, refresh, delete. Responses mode, Base URL overrides, catalog per capability și policy rămân în Plugins complet.
Codex (autentificare ChatGPT)
Codex (ChatGPT) nu cere cheie. Cu login Codex CLI (codex login ca OS user), apare
adminilor și oferă GPT-6 Astra, GPT-6.1 Sol (gpt-6.1-sol), GPT-6.1 Terra (gpt-6.1-terra), GPT-6 Sol, GPT-6 Luna, GPT-5.6 Sol, Terra, Luna, GPT-5.5 și GPT-5.3 Codex
Spark prin sesiunea ChatGPT, în funcție de accesul la modele al contului autentificat. Tokenurile se citesc din
auth.json, se reîmprospătează cu același OAuth și se scriu înapoi; valorile nu se loghează.
Cererile vin din backend, nu task container, deci funcționează cu Work. Este admin-only
fiindcă folosește abonamentul proprietarului. Ascundeți cu
CODEX_OAUTH_MODELS_ENABLED=false sau indicați alt login prin CODEX_HOME.
Amazon Bedrock
Furnizorul inclus Amazon Bedrock primește o cheie API Bedrock, pe termen scurt sau lung, din consola Amazon Bedrock. Salvați-o în setările furnizorului sau setați AWS_BEARER_TOKEN_BEDROCK pe server. Nu necesită AWS SDK, pereche de chei de acces sau semnare IAM.
Libre WebUI comunică cu endpointul bedrock-mantle.<region>.api.aws al regiunii și listează fiecare model pe care contul îl poate apela acolo, la fel cum OpenRouter își listează catalogul. Modelele pe care contul nu le poate folosi încă, de exemplu din cauza modului de retenție a datelor, sunt omise din listă. Alegeți regiunea cu setarea Region. Aceasta comută doar între gazdele Bedrock, deci cheia nu poate fi trimisă niciodată în altă parte, iar schimbarea ei păstrează cheia salvată.
Modelele Claude (anthropic.*) rulează prin Anthropic Messages API din Bedrock, așa că gândirea, instrumentele și plafoanele de tokeni se comportă ca la furnizorul Anthropic. Orice alt model folosește Chat Completions. Bedrock servește unele familii pe o a doua rută Chat Completions; Libre WebUI încearcă acea rută când Bedrock spune că un model se află acolo și o reține. Chat, Work și motorul Strands pot folosi toate aceste modele, iar utilizarea apare în analytics sub furnizor.
În Regiunile comerciale, AWS servește Claude Haiku 5.5 și Claude Sonnet 5.5 doar pe bedrock-runtime, prin profiluri de inferență cross-Region, așa că lista de modele Mantle nu le include niciodată. Catalogul adaugă global.anthropic.claude-haiku-5-5 și global.anthropic.claude-sonnet-5-5, iar orice ID de profil de inferență Claude (global., us., eu., au. sau jp.) este trimis cu aceeași cheie API către bedrock-runtime.<region>.amazonaws.com/anthropic/v1/messages din Regiunea selectată. Cheia merge în continuare doar către cele două gazde Bedrock ale acelei Regiuni. Contul dumneavoastră are în continuare nevoie de acces la model în Amazon Bedrock.
Modal
Furnizorul inclus Modal apelează routerul de inferență partajat al Modal,
https://inference.us-west.modal.direct/v1, cu Chat Completions. Ajunge la Shared
Endpoints din workspace-ul dumneavoastră Modal, pe care Modal le facturează per token.
- Creați un Shared Endpoint pentru fiecare model dorit, din fila Endpoints din
dashboardul Modal sau cu
modal endpoint create --shared --model moonshotai/Kimi-K3. - Creați un proxy token în setările dashboardului Modal sau cu
modal workspace proxy-tokens create. - Uniți ID-ul și secretul tokenului cu un punct,
wk-<id>.ws-<secret>, și salvați rezultatul ca cheie API a furnizorului sau setațiMODAL_PROXY_TOKENpe server.
Libre WebUI listează apoi, din /v1/models al routerului, fiecare endpoint la care
ajunge tokenul, cu fereastra de context și dacă modelul face raționament. Routerul
cunoaște un model doar după hostname-ul endpointului său, de exemplu
acme--ep-muse-spark-open-816b-a42b-server.us-west.modal.direct, așa că acesta este
ID-ul de model trimis de Libre WebUI; selectorul de modele îl afișează după numele
endpointului, aici „Muse Spark Open 816B A42B”. Un model fără endpoint în
workspace-ul dumneavoastră răspunde unknown inference model.
Fiecare cerere dintr-o conversație poartă același Modal-Routing-Affinity-Key,
derivat din model și din primul mesaj al conversației, astfel încât Modal o
direcționează către containerul care are deja promptul conversației în cache. Work
face la fel pentru fiecare pas al buclei de agent dintr-o rulare. Tokenii de intrare
din cache costă o fracțiune din tariful normal. Când compactarea rescrie istoricul,
cheia se schimbă, așa cum recomandă Modal.
Pentru a apela direct un singur endpoint, setați Full API endpoint URL al furnizorului la
URL-ul acestuia (modal endpoint info <name> îl afișează ca service_url) urmat de
/v1/chat/completions. Așa se ajunge la un Dedicated Endpoint; acolo modelul își
păstrează numele de pe Hugging Face, de exemplu moonshotai/Kimi-K3, nume folosit și
de lista inclusă pentru modelele partajate Modal înainte de salvarea unui token.
Shared Endpoints limitează cererile simultane per model și răspund 429 peste limită.
OpenCode în Work poate folosi același token. Cu MODAL_PROXY_TOKEN setat pe server
sau cu un login Modal salvat prin opencode auth login, un model modal/… rulează
în sandbox, iar tokenul este trimis exclusiv către inference.us-west.modal.direct.
Baseten
Furnizorul inclus Baseten apelează Model APIs de la Baseten,
https://inference.baseten.co/v1, cu Chat Completions. Baseten găzduiește modelele
și facturează per token, deci nu trebuie să implementați nimic în prealabil.
- Creați o cheie API personală în dashboardul Baseten, la Settings > API keys.
- Salvați-o ca cheie API a furnizorului sau setați
BASETEN_API_KEYpe server.
Libre WebUI listează apoi catalogul Model APIs din /v1/models, cu fereastra de
context a fiecărui model și dacă face raționament. Modelele de decizie Baseten
(decision-models/…) răspund doar la System One API de la Baseten, așa că sunt
listate ca modele de decizie în loc de modele de chat; vedeți
Modele de decizie. Modelele își păstrează slugurile Baseten, de exemplu
zai-org/GLM-5.3 sau moonshotai/Kimi-K3; selectorul le afișează ca „GLM 5.3” de
la Z.ai și „Kimi K3” de la Moonshot AI. O variantă Fast rulează aceleași ponderi
pe capacitate dedicată, la propriul preț.
Majoritatea acestor modele fac raționament în mod implicit. Controlul de gândire din
chat setează reasoning_effort al Baseten: Low și High sunt trimise ca
atare, setarea din mijloc lasă modelul la propria adâncime implicită, iar Off
trimite none. Extra high trimite high, deoarece modelele Baseten nu sunt de
acord asupra nivelului de deasupra: unele acceptă xhigh, altele doar max, iar
altele niciunul. Baseten documentează câteva excepții: Muse Spark Open și Beam fac
mereu raționament, iar GLM 5.3 încă face un raționament ușor cu none.
Raționamentul anterior este trimis înapoi ca reasoning_content, pe care Beam îl
cere la fiecare răspuns anterior.
Fiecare cerere dintr-o conversație poartă aceeași cheie x-session-affinity,
derivată din model și din primul mesaj al conversației, astfel încât Baseten o
direcționează către replica ce are deja promptul conversației în cache. Work face la
fel pentru fiecare pas al buclei de agent dintr-o rulare. Când compactarea rescrie
istoricul, cheia se schimbă.
Pentru a apela în schimb o implementare dedicată, setați Full API endpoint URL al
furnizorului la
https://model-<model id>.api.baseten.co/environments/production/sync/v1/chat/completions.
Aceeași cheie API funcționează și acolo.
OpenCode în Work poate folosi aceeași cheie. Cu BASETEN_API_KEY setat pe server
sau cu un login Baseten salvat prin opencode auth login, un model baseten/…
rulează în sandbox, iar cheia este trimisă exclusiv către inference.baseten.co.
Furnizor inclus sau importat
Sunt incluse OpenAI, Anthropic, Gemini, Groq, Mistral, DeepSeek, Meta, Modal, Baseten, Amazon Bedrock, OpenRouter, Kimi Code, Hugging Face, GitHub Models, MLX LM local și altele. Folosiți inclus când protocol/auth se potrivesc.
Exemplu minim importat:
{
  "id": "private-ai-gateway",
  "name": "Private AI Gateway",
  "type": "completion",
  "endpoint": "http://ai-gateway:8080/v1/chat/completions",
  "api_mode": "chat_completions",
  "auth": {
    "header": "Authorization",
    "prefix": "Bearer ",
    "key_env": "PRIVATE_AI_GATEWAY_API_KEY"
  },
  "model_map": ["gateway-chat"]
}
Importați din Settings > Plugins, activați și salvați cheia contului. Adăugați
variabile pentru Base URL, path, discovery sau endpoint capability. Exemplul complet:
plugins/openai.json.
Pentru gateway fără auth în rețea de încredere, setați auth.header și auth.key_env
goale și omiteți auth.prefix. Libre nu cere/trimite key.
Chat Completions sau Responses
| API mode | Path implicit | Câmp |
|---|---|---|
chat_completions | /chat/completions | messages |
responses | /responses | input |
OpenAI inclus expune API Mode. Libre normalizează output completed/streamed spre Chat/Work, cu replay limitat pentru reasoning/tools. Schimbarea mode schimbă path, nu protocol upstream.
Base URL sau endpoint complet
Ordine:
- Override complet
endpointnon-default. base_urlplusapi_pathopțional.- Endpointul definiției.
https://gateway.example/v1
https://gateway.example/v1/chat/completions
https://gateway.example/v1/responses
API Path pentru altă operație relativă. Legacy Full Endpoint doar URL complet,
cu prioritate. Sufixele /chat/completions, /completions, /responses determină semantica.
După route/key salvați înainte de test. Ruta custom cu auth cere credentiale ale aceluiași cont. Plugin fără auth lasă câmpuri goale. Cheia de mediu a operatorului nu merge la destinație user, doar bundled trusted.
Discovery și Model IDs
Selectați provider activ și Refresh models. Discovery rulează automat dacă lipsește
sau e mai vechi decât PLUGIN_MODEL_DISCOVERY_TTL_MS.
| Rezultat | Sens |
|---|---|
| Catalog updated | Lista s-a schimbat |
| Catalog already up to date | Aceeași listă |
| API key needed | Nu s-a trimis; rămâne catalog anterior |
| Catalog could not be loaded | Indisponibil sau răspuns inutil |
Cheia doar env nu se folosește cu installed definition; mesajul explică. Speech/image/embedding apar cu labels, nu în Chat picker.
URL /models:
- ruta
/modelsneschimbată; - sufixele
/chat/completions,/completions,/responses,/embeddings,/messagesînlocuite; - altfel
/modelsadăugat.
https://gateway.example/v1/chat/completions
https://gateway.example/v1/responses

-> https://gateway.example/v1/models
Pentru URL explicit, declarați models_endpoint în variables:
{
  "name": "models_endpoint",
  "type": "string",
  "label": "Models Endpoint",
  "default": "https://gateway.example/v1/models"
}
Valoarea moștenită/admin are prioritate. Proprietatea top-level nu se citește. Se așteaptă data:
{
  "data": [{ "id": "gateway-chat" }, { "id": "gateway-code" }]
}
ID-urile sunt per utilizator, fără rescriere JSON. Fără discovery, păstrați model_map.
Catalogul read-only și labels nu sunt health checks. ID-urile nu sunt global unice;
Chat salvează provider identity și marchează indisponibil în loc de rutare silențioasă.
Generare imagini separată
OpenAI inclus folosește https://api.openai.com/v1/images/generations și implicit
gpt-image-2, păstrând ID-uri vechi ca fallback. Chat Base URL custom nu primește
imagini. Lăsați image_endpoint gol sau setați URL complet. Se trimite doar furnizorului selectat.
Gateway HTTP sigur
Endpointurile pot fi HTTP/HTTPS. HTTP este pentru LAN/Tailscale/container network de încredere și trimite chei/prompturi necriptat. Preferabil HTTPS/TLS.
| Locație backend | Exemplu |
|---|---|
| Proces nativ | http://127.0.0.1:8081/v1 |
| Compose service | http://ai-gateway:8080/v1 |
| Container spre host | http://host.docker.internal:8081/v1 |
| LAN/Tailscale | http://192.168.1.20:8081/v1 |
În container, localhost este containerul Libre. Sunt acceptate doar HTTP/HTTPS,
destinația finală este validată înainte de credentiale și redirecturile nu sunt urmate.
Verificarea gatewayului
curl http://ai-gateway:8080/v1/models \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY'
Chat Completions:
curl http://ai-gateway:8080/v1/chat/completions \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "messages": [{"role": "user", "content": "Reply with: ready"}],
    "stream": false
  }'
Responses:
curl http://ai-gateway:8080/v1/responses \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "input": "Reply with: ready",
    "store": false
  }'
După succes, configurați aceeași rută, mode, credential și ID, activați, Refresh models și selectați în Chat. Work cere tool calls compatibile.
Depanare
| Simptom | Verificare |
|---|---|
| Încă bundled endpoint | Ștergeți override, salvați Base URL/API Path |
| Payload greșit | Potriviți API Mode și sufix |
| Refresh fără ID | /models, data[].id, models_endpoint, model_map |
| Model vechi | Salvați conexiunea pentru curățare |
| Key lipsă | Credential per user pe ruta custom |
| Docker nu ajunge localhost | Service Compose, alias host, adresă privată |
| Chat da, imagini nu | image_endpoint separat |
| Chat da, Work nu | Tool calls compatibile |
| Redirect | URL final validat |
Detalii în Plugins și Depanare.
Mulțumiri
Ghidul și experiența 0.16.0 au fost modelate de ZhengJin (@fangzhengjin) și feedback-ul din #163.