เชื่อมต่อผู้ให้บริการภายนอกและที่โฮสต์เอง
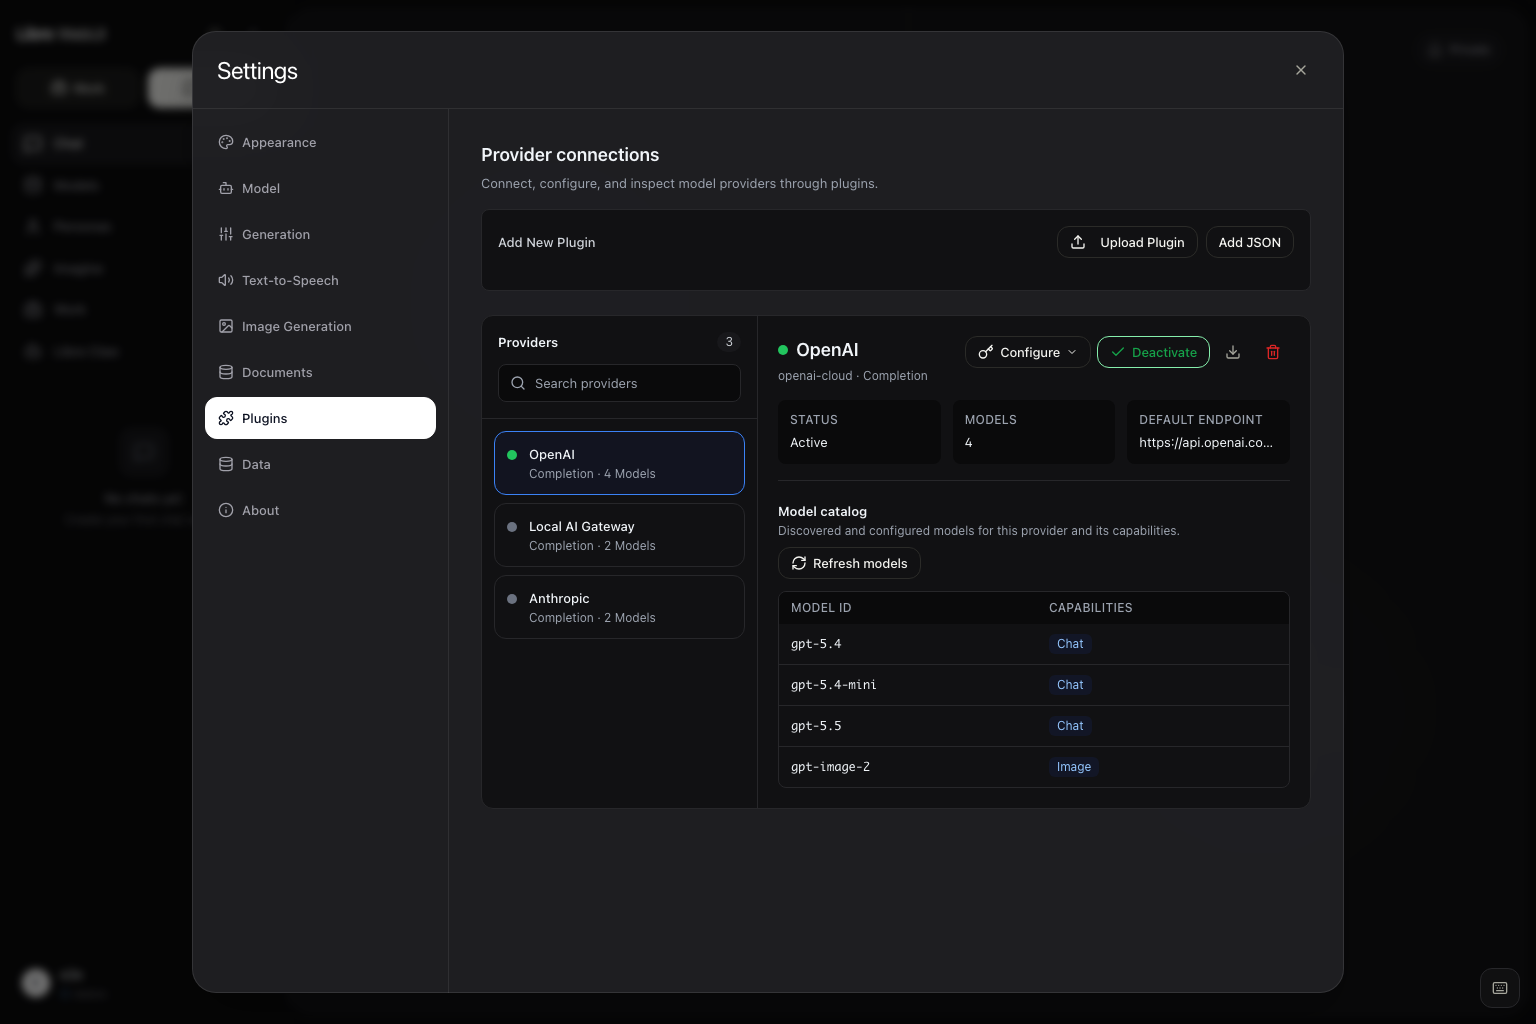
Libre WebUI 0.16.0 เพิ่มพื้นที่เฉพาะสำหรับ การเชื่อมต่อผู้ให้บริการ ภายใน การตั้งค่า > ปลั๊กอิน คุณสามารถใช้พื้นที่นี้เพื่อเปิดใช้ผู้ให้บริการที่มีมาให้ ชี้ปลั๊กอินที่เข้ากันได้ไปยัง API อื่น ตรวจดูรายการโมเดลที่มีผลจริง หรือเชื่อมต่อเกตเวย์ที่โฮสต์เองบนเครือข่ายที่เชื่อถือได้
Libre WebUI รองรับรูปแบบการสื่อสารกับผู้ให้บริการต่อไปนี้:
- OpenAI Chat Completions;
- OpenAI Responses;
- Anthropic Messages; และ
- เนื้อหาและการเรียกใช้ฟังก์ชันของ Google Gemini
ข้อกำหนด Anthropic และ Gemini ที่มีมาให้ใช้อะแดปเตอร์เฉพาะ ซึ่งเลือกตามข้อมูลระบุผู้ให้บริการ ผู้ให้บริการที่นำเข้าใหม่จะใช้รูปแบบของ OpenAI Chat Completions หรือ OpenAI Responses การชี้ไปยัง API ที่เข้ากันได้กับ Anthropic หรือ Gemini จะไม่เลือกอะแดปเตอร์ที่มีมาให้โดยอัตโนมัติ ผู้ให้บริการที่มีโครงสร้างคำขอ การสตรีม การเรียกใช้เครื่องมือ หรือการตอบกลับแบบอื่นต้องมีอะแดปเตอร์ฝั่งแบ็กเอนด์ JSON ของปลั๊กอินมีไว้เพื่ออธิบายการกำหนดเส้นทางและการตั้งค่าเท่านั้น ไม่ได้แปลงโพรโทคอลที่ไม่เกี่ยวข้องกัน
เปิดหน้า Provider connections
- ลงชื่อเข้าใช้แล้วเปิด การตั้งค่า > ปลั๊กอิน
- ค้นหารายชื่อผู้ให้บริการในบานหน้าต่างด้านซ้าย
- เลือกผู้ให้บริการเพื่อตรวจสอบสถานะการเปิดใช้และรายการโมเดลที่มีผลจริง
- เปิดใช้ผู้ให้บริการสำหรับบัญชีของคุณ
- เลือก กำหนดค่า เฉพาะเมื่อต้องการบันทึกข้อมูลรับรองหรือกำหนดค่าการเชื่อมต่อทับค่าเดิม
ส่วนกำหนดค่าผู้ให้บริการจะปิดไว้โดยค่าเริ่มต้น ผู้ดูแลระบบจะเห็นการตั้งค่าการเชื่อมต่อก่อน ส่วนตัวควบคุมการสุ่มตัวอย่าง เช่น temperature และขีดจำกัดโทเค็น จะอยู่ใต้ส่วน พารามิเตอร์ขั้นสูง ที่ย่อแยกต่างหาก ค่าเริ่มต้นที่รับทอดมาจะแสดงเป็นคำแนะนำ แทนที่จะกรอกล่วงหน้าเป็นค่าที่ทับการตั้งค่าของบัญชี
ข้อกำหนดปลั๊กอินเป็นการตั้งค่าที่ใช้ร่วมกันทั้งระบบ จึงมีเพียงผู้ดูแลระบบที่นำเข้า ติดตั้ง อัปเดต หรือลบได้ ผู้ใช้ที่ยืนยันตัวตนแต่ละรายจะควบคุมสถานะการเปิดใช้ ข้อมูลรับรอง และการตั้งค่าการสร้างผลลัพธ์ที่ได้รับอนุญาตของตนเอง
เพิ่มการเชื่อมต่อแบบเร็ว
การตั้งค่า > การเชื่อมต่อ เป็นทางลัดสำหรับกรณีทั่วไป ซึ่งมีปลายทางที่เข้ากันได้กับ OpenAI หนึ่งรายการและ API key หนึ่งค่า ผู้ดูแลระบบจะเห็นการ์ดของสภาพแวดล้อม Ollama ภายในเครื่องพร้อมสถานะการทำงานและรุ่น รายการการเชื่อมต่อที่เข้ากันได้กับ OpenAI และแบบฟอร์มขนาดเล็กสำหรับเพิ่มรายการใหม่
การเพิ่มการเชื่อมต่อต้องระบุชื่อที่แสดง URL สำหรับ Chat Completions แบบเต็ม และ API key ซึ่งไม่บังคับ Libre WebUI จะสร้าง ID การเชื่อมต่อจากชื่อ ติดตั้งข้อกำหนดผู้ให้บริการ เก็บคีย์ไว้ฝั่งเซิร์ฟเวอร์ เปิดใช้การเชื่อมต่อ และสอบถามปลายทางว่ามีโมเดลใดให้บริการ โมเดลที่ค้นพบจะแทนที่รายการชั่วคราวและปรากฏในตัวเลือกโมเดลของ Chat
แต่ละแถวจะแสดงปลายทาง จำนวนโมเดล สถานะการบันทึกคีย์ สวิตช์เปิดใช้ ปุ่มรีเฟรชโมเดล และปุ่มลบ ตัวเลือกที่ซับซ้อนกว่านี้ เช่น โหมด Responses API การกำหนด Base URL ทับค่าเดิม รายการแยกตามความสามารถ และนโยบายพารามิเตอร์การสร้างผลลัพธ์ จะยังอยู่ในพื้นที่ การตั้งค่า > ปลั๊กอิน แบบเต็มที่อธิบายไว้ข้างต้น
Codex (ลงชื่อเข้าใช้ ChatGPT)
ผู้ให้บริการ Codex (ChatGPT) ที่มีมาให้ไม่ต้องใช้ API key เมื่อลงชื่อเข้าใช้ Codex CLI ด้วย codex login โดยใช้บัญชีระบบปฏิบัติการของเซิร์ฟเวอร์ ผู้ให้บริการนี้จะปรากฏต่อผู้ดูแลระบบและให้ใช้ GPT-6 Astra, GPT-6.1 Sol (gpt-6.1-sol), GPT-6.1 Terra (gpt-6.1-terra), GPT-6 Sol, GPT-6 Luna, GPT-5.6 Sol, Terra, Luna, GPT-5.5 และ GPT-5.3 Codex Spark ผ่านเซสชัน ChatGPT ตามสิทธิ์เข้าถึงโมเดลของบัญชีที่ลงชื่อเข้าใช้ ระบบจะอ่านโทเค็นการเข้าถึงจาก auth.json ของ CLI รีเฟรชด้วยไคลเอนต์ OAuth เดียวกับที่ CLI ใช้ และเขียนกลับเพื่อให้ CLI ทำงานต่อได้ โดยค่าของโทเค็นจะไม่ปรากฏในบันทึกระบบ
คำขอจะส่งจากแบ็กเอนด์ ไม่ใช่จากภายในคอนเทนเนอร์ของงาน โมเดลเหล่านี้จึงใช้กับ Work ผ่านวงรอบเครื่องมือแบบแยกได้ตามปกติ ผู้ให้บริการนี้จำกัดเฉพาะผู้ดูแลระบบ เพราะทุกการเรียกใช้จะหักจากการสมัครสมาชิก ChatGPT ของเจ้าของเซิร์ฟเวอร์ ซ่อนผู้ให้บริการนี้ทั้งหมดด้วย CODEX_OAUTH_MODELS_ENABLED=false หรือใช้ CODEX_HOME เพื่อชี้ไปยังเซสชันการลงชื่อเข้าใช้อื่น
Amazon Bedrock
ผู้ให้บริการ Amazon Bedrock ที่มีมาให้รับ Bedrock API key ทั้งแบบระยะสั้นหรือระยะยาวจากคอนโซล Amazon Bedrock บันทึกไว้ในการตั้งค่าของผู้ให้บริการ หรือตั้ง AWS_BEARER_TOKEN_BEDROCK บนเซิร์ฟเวอร์ ไม่ต้องใช้ AWS SDK คู่ access key หรือการเซ็น IAM
Libre WebUI เรียกไปยังเอนด์พอยต์ bedrock-mantle.<region>.api.aws ของ Region และแสดงรายการทุกโมเดลที่บัญชีเรียกใช้ได้ที่นั่น เช่นเดียวกับที่ OpenRouter แสดงแค็ตตาล็อกของตน โมเดลที่บัญชียังใช้ไม่ได้ เช่นเพราะโหมดการเก็บรักษาข้อมูล จะไม่แสดงในรายการ เลือก Region ด้วยการตั้งค่า Region การตั้งค่านี้สลับได้เฉพาะระหว่างโฮสต์ Bedrock เท่านั้น key จึงไม่มีทางถูกส่งไปที่อื่น และการเปลี่ยนค่านี้จะคง key ที่บันทึกไว้
โมเดล Claude (anthropic.*) ทำงานผ่าน Anthropic Messages API ของ Bedrock ดังนั้นการคิด เครื่องมือ และเพดาน token จึงทำงานเหมือนกับผู้ให้บริการ Anthropic โมเดลอื่นทั้งหมดใช้ Chat Completions Bedrock ให้บริการบางตระกูลบนเส้นทาง Chat Completions ที่สอง Libre WebUI จะลองเส้นทางนั้นเมื่อ Bedrock แจ้งว่าโมเดลอยู่ที่นั่นและจดจำไว้ แชต Work และเอนจิน Strands ใช้โมเดลเหล่านี้ได้ทั้งหมด และการใช้งานจะแสดงภายใต้ผู้ให้บริการในการวิเคราะห์
ใน Region เชิงพาณิชย์ AWS ให้บริการ Claude Haiku 5.5 และ Claude Sonnet 5.5 เฉพาะบน bedrock-runtime ผ่าน cross-Region inference profile ดังนั้นรายการโมเดลของ Mantle จะไม่มีสองโมเดลนี้ แค็ตตาล็อกจึงเพิ่ม global.anthropic.claude-haiku-5-5 และ global.anthropic.claude-sonnet-5-5 และ ID inference profile ของ Claude ใดๆ (global., us., eu., au. หรือ jp.) จะถูกส่งด้วย API key เดียวกันไปยัง bedrock-runtime.<region>.amazonaws.com/anthropic/v1/messages ของ Region ที่เลือก key ยังคงถูกส่งไปเฉพาะโฮสต์ Bedrock สองแห่งของ Region นั้น บัญชีของคุณยังต้องมีสิทธิ์เข้าถึงโมเดลใน Amazon Bedrock
Modal
ผู้ให้บริการ Modal ที่มีมาให้จะเรียกเราเตอร์การอนุมานแบบใช้ร่วมกันของ Modal ที่ https://inference.us-west.modal.direct/v1 ด้วย Chat Completions และเข้าถึง Shared Endpoint ใน workspace ของ Modal ของคุณ ซึ่ง Modal คิดค่าบริการตามจำนวน token
- สร้าง Shared Endpoint สำหรับแต่ละโมเดลที่ต้องการ จากแท็บ Endpoints ในแดชบอร์ดของ Modal หรือด้วย
modal endpoint create --shared --model moonshotai/Kimi-K3 - สร้าง proxy token ในการตั้งค่าของแดชบอร์ด Modal หรือด้วย
modal workspace proxy-tokens create - ต่อ ID ของ token กับ secret ด้วยจุดเป็น
wk-<id>.ws-<secret>แล้วบันทึกผลลัพธ์เป็น API key ของผู้ให้บริการ หรือตั้งMODAL_PROXY_TOKENบนเซิร์ฟเวอร์
จากนั้น Libre WebUI จะแสดงทุกเอนด์พอยต์ที่ token เข้าถึงได้จาก /v1/models ของเราเตอร์ พร้อมหน้าต่างบริบทและข้อมูลว่าโมเดลให้เหตุผลหรือไม่ เราเตอร์รู้จักโมเดลจากชื่อโฮสต์ของเอนด์พอยต์เท่านั้น เช่น acme--ep-muse-spark-open-816b-a42b-server.us-west.modal.direct ชื่อนี้จึงเป็น ID โมเดลที่ Libre WebUI ส่งไป ส่วนตัวเลือกโมเดลจะแสดงโมเดลด้วยชื่อของเอนด์พอยต์ ในตัวอย่างนี้คือ "Muse Spark Open 816B A42B" โมเดลที่ไม่มีเอนด์พอยต์ใน workspace ของคุณจะตอบกลับว่า unknown inference model
ทุกคำขอในการสนทนาเดียวกันจะมี Modal-Routing-Affinity-Key เดียวกัน ซึ่งได้มาจากโมเดลและข้อความแรกของการสนทนา Modal จึงส่งคำขอไปยังคอนเทนเนอร์ที่เก็บพรอมต์ของการสนทนาไว้ในแคชอยู่แล้ว Work ทำแบบเดียวกันกับทุกขั้นของวงรอบเอเจนต์ในการรันแต่ละครั้ง token อินพุตที่แคชไว้มีค่าใช้จ่ายเพียงเศษเสี้ยวของอัตราปกติ เมื่อการบีบอัดเขียนประวัติใหม่ คีย์จะเปลี่ยนไปตามที่ Modal แนะนำ
หากต้องการเรียกเอนด์พอยต์เดียวโดยตรง ให้ตั้ง URL API endpoint แบบเต็ม ของผู้ให้บริการเป็น URL ของเอนด์พอยต์นั้น (modal endpoint info <name> แสดง URL นี้เป็น service_url) ตามด้วย /v1/chat/completions นี่คือวิธีเข้าถึง Dedicated Endpoint ซึ่งโมเดลจะคงชื่อ Hugging Face ไว้ เช่น moonshotai/Kimi-K3 และเป็นชื่อเดียวกับที่รายการที่มีมาให้ใช้เรียกโมเดลแบบใช้ร่วมกันของ Modal ก่อนบันทึก token Shared Endpoint จำกัดจำนวนคำขอพร้อมกันต่อโมเดล และตอบกลับ 429 เมื่อเกินขีดจำกัด
OpenCode ใน Work ใช้ token เดียวกันนี้ได้ เมื่อตั้ง MODAL_PROXY_TOKEN บนเซิร์ฟเวอร์ หรือบันทึกการลงชื่อเข้าใช้ Modal ด้วย opencode auth login โมเดล modal/… จะทำงานในแซนด์บ็อกซ์ และ token จะถูกส่งไปที่ inference.us-west.modal.direct เท่านั้น
Baseten
ผู้ให้บริการ Baseten ที่มีมาให้จะเรียก Model APIs ของ Baseten ที่ https://inference.baseten.co/v1 ด้วย Chat Completions Baseten โฮสต์โมเดลและคิดค่าบริการตามจำนวน token จึงไม่ต้องติดตั้งใช้งานอะไรก่อน
- สร้าง API key ส่วนตัวในแดชบอร์ดของ Baseten ที่ Settings > API keys
- บันทึกเป็น API key ของผู้ให้บริการ หรือตั้ง
BASETEN_API_KEYบนเซิร์ฟเวอร์
จากนั้น Libre WebUI จะแสดงแค็ตตาล็อก Model APIs จาก /v1/models พร้อมหน้าต่างบริบทของแต่ละโมเดลและข้อมูลว่าโมเดลให้เหตุผลหรือไม่ โมเดลตัดสินใจของ Baseten (decision-models/…) ตอบเฉพาะ System One API ของ Baseten จึงแสดงเป็นโมเดลตัดสินใจแทนโมเดลแชต ดู โมเดลตัดสินใจ โมเดลจะคง slug ของ Baseten ไว้ เช่น zai-org/GLM-5.3 หรือ moonshotai/Kimi-K3 ส่วนตัวเลือกจะแสดงเป็น "GLM 5.3" โดย Z.ai และ "Kimi K3" โดย Moonshot AI รุ่น Fast ใช้น้ำหนักโมเดลชุดเดียวกันบนทรัพยากรเฉพาะในราคาของตัวเอง
โมเดลส่วนใหญ่เหล่านี้ให้เหตุผลโดยค่าเริ่มต้น ตัวควบคุมการคิดของแชตจะกำหนด reasoning_effort ของ Baseten: ต่ำ และ สูง จะถูกส่งไปตามนั้น ระดับกลางจะปล่อยให้โมเดลใช้ความลึกเริ่มต้นของตัวเอง และ ปิด จะส่ง none สูงมาก จะส่ง high เพราะโมเดลของ Baseten รองรับระดับที่สูงกว่านั้นไม่ตรงกัน: บางโมเดลรับ xhigh บางโมเดลรับเพียง max และบางโมเดลไม่รับทั้งสองค่า Baseten ระบุข้อยกเว้นไว้บางกรณี ได้แก่ Muse Spark Open และ Beam ให้เหตุผลเสมอ และ GLM 5.3 ยังให้เหตุผลเล็กน้อยแม้ได้รับ none การให้เหตุผลก่อนหน้าจะถูกส่งกลับเป็น reasoning_content ซึ่ง Beam กำหนดให้มีในทุกคำตอบก่อนหน้า
ทุกคำขอในการสนทนาเดียวกันจะมีคีย์ x-session-affinity เดียวกัน ซึ่งได้มาจากโมเดลและข้อความแรกของการสนทนา Baseten จึงส่งคำขอไปยังเรพลิกาที่เก็บพรอมต์ของการสนทนาไว้ในแคชอยู่แล้ว Work ทำแบบเดียวกันกับทุกขั้นของวงรอบเอเจนต์ในการรันแต่ละครั้ง เมื่อการบีบอัดเขียนประวัติใหม่ คีย์จะเปลี่ยนไป
หากต้องการเรียกการติดตั้งใช้งานเฉพาะแทน ให้ตั้ง URL API endpoint แบบเต็ม ของผู้ให้บริการเป็น https://model-<model id>.api.baseten.co/environments/production/sync/v1/chat/completions API key เดียวกันใช้ที่นั่นได้
OpenCode ใน Work ใช้คีย์เดียวกันนี้ได้ เมื่อตั้ง BASETEN_API_KEY บนเซิร์ฟเวอร์ หรือบันทึกการลงชื่อเข้าใช้ Baseten ด้วย opencode auth login โมเดล baseten/… จะทำงานในแซนด์บ็อกซ์ และคีย์จะถูกส่งไปที่ inference.baseten.co เท่านั้น
เลือกผู้ให้บริการที่มีมาให้หรือที่นำเข้า
Libre WebUI มีข้อกำหนดสำหรับ OpenAI, Anthropic, Gemini, Groq, Mistral, DeepSeek, Meta, Modal, Baseten, Amazon Bedrock, OpenRouter, Kimi Code ของ Moonshot AI, Hugging Face, GitHub Models, MLX LM ภายในเครื่อง และบริการโมเดลหรือสื่ออื่น ๆ เริ่มจากรายการที่มีมาให้เมื่อโพรโทคอลและข้อกำหนดการยืนยันตัวตนตรงกับบริการที่ต้องการใช้
สำหรับบริการอื่นที่เข้ากันได้ ผู้ดูแลระบบสามารถนำเข้าข้อกำหนดปลั๊กอินแบบ JSON ได้ ตัวอย่างขั้นต่ำต่อไปนี้อธิบายเกตเวย์ที่เข้ากันได้กับ OpenAI:
{
  "id": "private-ai-gateway",
  "name": "Private AI Gateway",
  "type": "completion",
  "endpoint": "http://ai-gateway:8080/v1/chat/completions",
  "api_mode": "chat_completions",
  "auth": {
    "header": "Authorization",
    "prefix": "Bearer ",
    "key_env": "PRIVATE_AI_GATEWAY_API_KEY"
  },
  "model_map": ["gateway-chat"]
}
นำเข้าไฟล์จาก การตั้งค่า > ปลั๊กอิน เปิดใช้ผู้ให้บริการ แล้วบันทึก API key สำหรับบัญชีที่จะใช้การเชื่อมต่อ เพิ่มตัวแปรการเชื่อมต่อในข้อกำหนดเมื่อผู้ดูแลระบบต้องการฟิลด์ที่แก้ไขได้สำหรับ Base URL เส้นทาง การค้นหาโมเดล หรือปลายทางเฉพาะความสามารถ ไฟล์ plugins/openai.json ที่มีมาให้เป็นตัวอย่างฉบับสมบูรณ์
สำหรับเกตเวย์บนเครือข่ายที่เชื่อถือได้ซึ่งตั้งใจให้ใช้งานโดยไม่ยืนยันตัวตน ให้ตั้ง auth.header และ auth.key_env เป็นสตริงว่างและไม่ระบุ auth.prefix จากนั้น Libre WebUI จะไม่เรียกขอหรือส่ง API key ให้ปลั๊กอินนั้น
เลือก Chat Completions หรือ Responses
ปลั๊กอินสร้างคำตอบที่เข้ากันได้กับ OpenAI สามารถใช้โหมด API แบบใดแบบหนึ่งต่อไปนี้:
| โหมด API | เส้นทางคำขอเริ่มต้น | ฟิลด์คำขอที่ใช้ทั่วไป |
|---|---|---|
chat_completions | /chat/completions | messages |
responses | /responses | input |
ผู้ให้บริการ OpenAI ที่มีมาให้แสดง API Mode ในหน้ากำหนดค่า Libre WebUI จะแปลงทั้งผลลัพธ์ Responses ที่เสร็จแล้วและที่กำลังสตรีมกลับไปยัง Chat และ Work รวมถึงเก็บสถานะการเล่นซ้ำแบบจำกัดสำหรับการใช้เหตุผลและการเรียกใช้เครื่องมือ
การเปลี่ยนโหมดจะเปลี่ยนเส้นทางการดำเนินการเริ่มต้น แต่ไม่เปลี่ยนโพรโทคอลที่เซิร์ฟเวอร์ต้นทางใช้ จึงควรเลือก Responses เฉพาะเมื่อเซิร์ฟเวอร์นั้นรองรับโครงสร้างคำขอและเหตุการณ์ของ Responses ที่เข้ากันได้
กำหนด Base URL หรือปลายทางแบบเต็ม
Libre WebUI เลือกเส้นทางสำหรับการสร้างคำตอบตามลำดับต่อไปนี้:
- ค่า
endpointแบบเต็มที่กำหนดทับค่าเริ่มต้น base_urlบวกapi_pathที่ไม่บังคับ- ปลายทางที่ประกาศไว้ในข้อกำหนดปลั๊กอิน
ใช้ Base URL สำหรับราก API:
https://gateway.example/v1
หากไม่มีเส้นทางกำหนดเอง โหมด Chat Completions จะส่งคำขอไปยัง:
https://gateway.example/v1/chat/completions
ส่วนโหมด Responses จะส่งคำขอไปยัง:
https://gateway.example/v1/responses
ใช้ API Path เมื่อผู้ให้บริการเปิดการดำเนินการที่เข้ากันได้บนเส้นทางอื่นซึ่งอ้างอิงจากรากนั้น ใช้ Legacy Full Endpoint เฉพาะเมื่อต้องระบุ URL ของการดำเนินการแบบเต็ม โดยปลายทางแบบเต็มจริงจะมีลำดับความสำคัญเหนือ Base URL และ API Path
ส่วนต่อท้ายปลายทางที่รู้จัก เช่น /chat/completions, /completions และ /responses ยังใช้ระบุรูปแบบของคำขอด้วย ส่วนเส้นทางการดำเนินการกำหนดเองที่ระบบไม่รู้จักจะคงโหมด API ที่เลือกไว้อย่างชัดเจน
หลังเปลี่ยนเส้นทางหรือ API key ให้บันทึกผู้ให้บริการอีกครั้งก่อนทดสอบใน Chat เมื่อปลั๊กอินประกาศการยืนยันตัวตน เส้นทางการเชื่อมต่อกำหนดเองต้องใช้ข้อมูลรับรองที่บันทึกโดยบัญชีเดียวกัน ปลั๊กอินที่ตั้งใจไม่ใช้การยืนยันตัวตนสามารถเว้นฟิลด์ยืนยันตัวตนทั้งสองช่องไว้ได้ Libre WebUI จะไม่ส่งคีย์จากตัวแปรสภาพแวดล้อมที่ผู้ดูแลระบบจัดการไปยังปลายทางที่ผู้ใช้กำหนด การใช้คีย์จากสภาพแวดล้อมเป็นค่าทดแทนสงวนไว้สำหรับเส้นทางที่มีมาให้และเชื่อถือได้เท่านั้น
ค้นหาหรือดูแล ID โมเดล
เลือกผู้ให้บริการ Chat ที่เปิดใช้อยู่ แล้วใช้ รีเฟรชโมเดล เพื่อค้นหาโมเดล Libre WebUI จะโหลดทั้งรายการของผู้ให้บริการที่เลือกและรายการโมเดลของ Chat ใหม่
การค้นหายังทำงานโดยอัตโนมัติด้วย โดยจะค้นหารายการของผู้ให้บริการที่เปิดใช้อยู่ใหม่เมื่อรายการหายไปหรือเก่ากว่า PLUGIN_MODEL_DISCOVERY_TTL_MS ดังนั้นโมเดลที่คุณเห็นจึงอิงตามผู้ให้บริการ ไม่ใช่ช่วงเวลาที่เปิดใช้ รีเฟรชโมเดล จะบังคับตรวจสอบทันทีและรายงานผลที่เกิดขึ้น:
| ผลลัพธ์ | ความหมาย |
|---|---|
| อัปเดตรายการแล้ว | ผู้ให้บริการตอบกลับและรายการโมเดลต่างจากที่จัดเก็บไว้ |
| รายการเป็นปัจจุบันแล้ว | ผู้ให้บริการตอบกลับด้วยรายการเดิม |
| ต้องใช้ API key | ไม่มีคีย์ที่ใช้งานได้ จึงไม่ได้ส่งคำขอ และยังแสดงรายการก่อนหน้า |
| โหลดรายการไม่ได้ | ติดต่อผู้ให้บริการไม่ได้หรือไม่มีข้อมูลที่นำไปใช้ได้ในคำตอบ |
คีย์ที่ตั้งไว้เฉพาะในสภาพแวดล้อมจะไม่ถูกใช้กับผู้ให้บริการที่ทำงานด้วยข้อกำหนดซึ่งติดตั้งเพิ่มแทนข้อกำหนดที่มีมาให้ ข้อความจะแจ้งให้ทราบเมื่อเป็นกรณีนี้ โมเดลเสียงพูด รูปภาพ และการฝังข้อมูลที่พบในรายการของผู้ให้บริการจะแสดงพร้อมป้ายความสามารถ แต่จะไม่ปรากฏในตัวเลือกโมเดลของ Chat
สำหรับเส้นทางที่เข้ากันได้กับ OpenAI ระบบจะกำหนด URL ของรายการโมเดลดังนี้:
- หากลงท้าย
/modelsใช้เดิม - แทน
/chat/completions,/completions,/responses,/embeddings,/messagesด้วย/models - มิฉะนั้นเพิ่ม
/models
ตัวอย่างเส้นทางสร้างคำตอบทั้งสองรายการจะให้ URL สำหรับค้นหาโมเดลเดียวกัน:
https://gateway.example/v1/chat/completions
https://gateway.example/v1/responses

-> https://gateway.example/v1/models
หากระบบกำหนด URL ที่ถูกต้องไม่ได้ ให้ประกาศ models_endpoint ในอาร์เรย์ variables ของปลั๊กอิน:
{
  "name": "models_endpoint",
  "type": "string",
  "label": "Models Endpoint",
  "default": "https://gateway.example/v1/models"
}
ค่าเริ่มต้นที่รับทอดมาหรือค่าที่ผู้ดูแลระบบบันทึกไว้จะมีลำดับความสำคัญเหนือที่อยู่ซึ่งระบบกำหนดขึ้น ระบบจะไม่อ่านพร็อพเพอร์ตี models_endpoint ระดับบนสุดของไฟล์กำหนด การค้นหาโมเดลคาดหวังคำตอบที่เข้ากันได้กับ OpenAI โดยมีอ็อบเจ็กต์โมเดลอยู่ในอาร์เรย์ data:
{
  "data": [{ "id": "gateway-chat" }, { "id": "gateway-code" }]
}
ID ที่ค้นพบจะจัดเก็บแยกตามผู้ใช้และไม่เขียนทับไฟล์ปลั๊กอินที่ใช้ร่วมกัน หากผู้ให้บริการไม่รองรับการค้นหาที่เข้ากันได้ ให้ดูแล ID โมเดลสำรองไว้ใน model_map ของ JSON ปลั๊กอิน รายการใน Provider connections เป็นแบบอ่านอย่างเดียว ป้ายความสามารถบอกว่าเส้นทางของปลั๊กอินใดแสดงโมเดลนั้น ไม่ใช่ผลตรวจสอบสถานะการทำงาน
ID โมเดลไม่จำเป็นต้องไม่ซ้ำกันทั้งระบบ Chat จะเก็บ ID ดิบควบคู่กับข้อมูลระบุผู้ให้บริการ Ollama หรือปลั๊กอินที่ตรงกัน จึงทำให้โมเดล Ollama และปลั๊กอินหลายรายการใช้ชื่อเดียวกันได้อย่างปลอดภัย หากผู้ให้บริการที่บันทึกไว้ใช้งานไม่ได้ Libre WebUI จะแสดงตัวเลือกนั้นว่าไม่พร้อมใช้งาน แทนที่จะส่งคำขอไปยังผู้ให้บริการอื่นโดยไม่แจ้งให้ทราบ
ตั้งค่าการสร้างรูปแยก
ผู้ให้บริการ OpenAI ที่มีมาให้รองรับการสร้างรูปผ่าน https://api.openai.com/v1/images/generations และใช้ gpt-image-2 เป็นค่าเริ่มต้นสำหรับการตั้งค่าใหม่ ID ของ GPT Image รุ่นเก่ายังคงอยู่ในรายการสำรอง เพื่อรองรับระบบเดิมที่ติดตั้งใช้งานและเข้ากันได้
เส้นทางของ Chat และรูปภาพแยกจากกันโดยตั้งใจ Base URL กำหนดเองของ Chat จะไม่รับคำขอสร้างรูปโดยอัตโนมัติ เว้น image_endpoint ว่างไว้เพื่อใช้ปลายทางรูปภาพที่ประกาศโดยปลั๊กอิน หรือตั้งเป็น URL การดำเนินการ Image API แบบเต็มที่เข้ากันได้เมื่อผู้ให้บริการรองรับ
ตัวเลือกโมเดลรูปภาพจะผูกกับผู้ให้บริการเช่นเดียวกับตัวเลือกใน Chat หากปลั๊กอินที่เปิดใช้สองรายการมี ID โมเดลรูปภาพเดียวกัน Libre WebUI จะส่งคำขอไปยังผู้ให้บริการที่เลือกในแผงรูปภาพเท่านั้น
เชื่อมต่อเกตเวย์ HTTP อย่างปลอดภัย
ปลายทางของผู้ให้บริการสามารถใช้ URL แบบเต็มที่เป็น HTTP หรือ HTTPS ได้ HTTP มีประโยชน์สำหรับเกตเวย์ที่โฮสต์เองบน LAN เครือข่าย Tailscale หรือเครือข่ายคอนเทนเนอร์ส่วนตัวที่เชื่อถือได้ แต่จะส่ง API key พรอมต์ ผลลัพธ์จากเครื่องมือ และเนื้อหาที่สร้างขึ้นโดยไม่มีการเข้ารหัสระหว่างส่ง ควรใช้ HTTPS ทุกครั้งที่เส้นทางข้ามขอบเขตเครือข่ายหรือเกตเวย์รองรับ TLS
คำขอมาจากแบ็กเอนด์ของ Libre WebUI ไม่ใช่จากเบราว์เซอร์ จึงต้องเลือกที่อยู่ที่แบ็กเอนด์นั้นเข้าถึงได้:
| ตำแหน่งแบ็กเอนด์ | ตัวอย่างรากของผู้ให้บริการ |
|---|---|
| กระบวนการแบบเนทีฟบนเครื่องเดียวกัน | http://127.0.0.1:8081/v1 |
| บริการ Docker Compose | http://ai-gateway:8080/v1 |
| จากคอนเทนเนอร์ไปยังโฮสต์ที่รองรับ | http://host.docker.internal:8081/v1 |
| โฮสต์บน LAN หรือ Tailscale ที่เชื่อถือได้ | http://192.168.1.20:8081/v1 |
ภายในคอนเทนเนอร์ localhost หมายถึงคอนเทนเนอร์ Libre WebUI เอง ไม่ได้หมายถึงบริการ Compose อื่นและไม่สามารถเข้าถึงโฮสต์ได้โดยอัตโนมัติ
Libre WebUI รับเฉพาะ URL ของผู้ให้บริการที่เป็น HTTP หรือ HTTPS ตรวจสอบปลายทางสุดท้ายก่อนเลือกข้อมูลรับรอง และไม่ติดตามการเปลี่ยนเส้นทางสำหรับคำขอถึงผู้ให้บริการหรือคำขอค้นหาโมเดล ให้กำหนด URL ของการดำเนินการสุดท้ายโดยตรง
ตรวจสอบเกตเวย์ก่อนเปิดใช้
ทดสอบการค้นหาโมเดลจากเครื่องหรือคอนเทนเนอร์ที่เรียกใช้แบ็กเอนด์ Libre WebUI:
curl http://ai-gateway:8080/v1/models \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY'
จากนั้นทดสอบการดำเนินการที่ตรงกับโหมด API ที่เลือก
Chat Completions:
curl http://ai-gateway:8080/v1/chat/completions \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "messages": [{"role": "user", "content": "Reply with: ready"}],
    "stream": false
  }'
Responses:
curl http://ai-gateway:8080/v1/responses \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "input": "Reply with: ready",
    "store": false
  }'
เมื่อการเรียกทดสอบทั้งสองทำงานแล้ว ให้กำหนดเส้นทาง โหมด ข้อมูลรับรอง และ ID โมเดลเดียวกันใน การเชื่อมต่อผู้ให้บริการ เปิดใช้ผู้ให้บริการ เลือก รีเฟรชโมเดล แล้วเลือกโมเดลที่ผูกกับผู้ให้บริการนั้นใน Chat ส่วน Work ก็ใช้โมเดลนี้ได้เมื่อโมเดลรองรับการเรียกใช้เครื่องมือที่เข้ากันได้อย่างเชื่อถือได้
การแก้ปัญหา
| อาการ | ตรวจสอบ |
|---|---|
| คำขอยังไปยังปลายทางที่มีมาให้ | ลบค่าปลายทางแบบเต็มที่กำหนดทับและล้าสมัย แล้วบันทึก Base URL และ API Path ที่ต้องการ |
| ผู้ให้บริการได้รับข้อมูลคำขอผิด | ตั้ง API Mode ให้ตรงกับโพรโทคอล Chat Completions หรือ Responses ของเซิร์ฟเวอร์ต้นทาง และตรวจสอบส่วนต่อท้ายสุดท้าย |
| รีเฟรชโมเดล ไม่คืน ID | ทดสอบ /models ตรวจสอบโครงสร้าง data[].id เปิดให้กำหนดตัวแปร models_endpoint หรือดูแล model_map |
| โมเดลเก่ายังอยู่หลังแก้เส้นทาง | บันทึกการเปลี่ยนแปลงการเชื่อมต่อ Libre WebUI จะล้างรายการโมเดลเก่าที่ค้นพบสำหรับผู้ใช้นั้นก่อนรีเฟรช |
| ระบบแจ้งว่าไม่มี API key | บันทึกข้อมูลรับรองแยกตามผู้ใช้สำหรับเส้นทางกำหนดเอง การใช้ค่าจากสภาพแวดล้อมของรายการที่มีมาให้จะไม่ตามค่าที่กำหนดทับ |
| ระบบ Docker เข้าถึง localhost ไม่ได้ | ใช้ชื่อบริการ Compose ของเกตเวย์ ชื่อแทนโฮสต์ที่รองรับ หรือที่อยู่บนเครือข่ายส่วนตัวซึ่งเข้าถึงได้ |
| Chat ทำงานแต่สร้างรูปไม่ได้ | กำหนด image_endpoint แบบเต็มแยกต่างหาก แล้วเลือกโมเดลที่เปิดให้ใช้ผ่านความสามารถด้านรูปภาพ |
| Chat ทำงานแต่ Work ปฏิเสธโมเดล | ตรวจสอบว่าโมเดลรองรับการเรียกใช้เครื่องมือที่เข้ากันได้ การสร้างข้อความเพียงอย่างเดียวยังไม่เพียงพอ |
| ผู้ให้บริการส่งการเปลี่ยนเส้นทางกลับมา | กำหนด URL สุดท้ายที่ผ่านการตรวจสอบโดยตรง เพราะ Libre WebUI ตั้งใจไม่ติดตามการเปลี่ยนเส้นทางของผู้ให้บริการ |
รายละเอียดเกี่ยวกับการกำหนดเส้นทาง ข้อมูลรับรอง สถานะการเล่นซ้ำ และการทำงานของการอนุญาต ดูได้ที่ ปลั๊กอิน ส่วนข้อผิดพลาดเฉพาะการติดตั้งใช้งาน ดู การแก้ปัญหา
ขอบคุณชุมชน
คู่มือนี้และประสบการณ์ใช้งาน Provider connections ใน Libre WebUI 0.16.0 ได้รับการหล่อหลอมจาก ZhengJin (@fangzhengjin) ซึ่งข้อเสนอแนะโดยละเอียดเกี่ยวกับผู้ให้บริการภายนอกและแนวคิดประสบการณ์ผู้ใช้ที่สร้างด้วย AI ใน #163 ช่วยกำหนดกระบวนงานนี้