Łączenie dostawców zewnętrznych i samodzielnie hostowanych
Libre WebUI 0.16.0 dodaje obszar Połączenia dostawców w Ustawienia > Wtyczki. Służy do aktywacji dołączonego dostawcy, skierowania zgodnej wtyczki do innego API, sprawdzenia efektywnego katalogu lub połączenia samodzielnej bramy w zaufanej sieci.
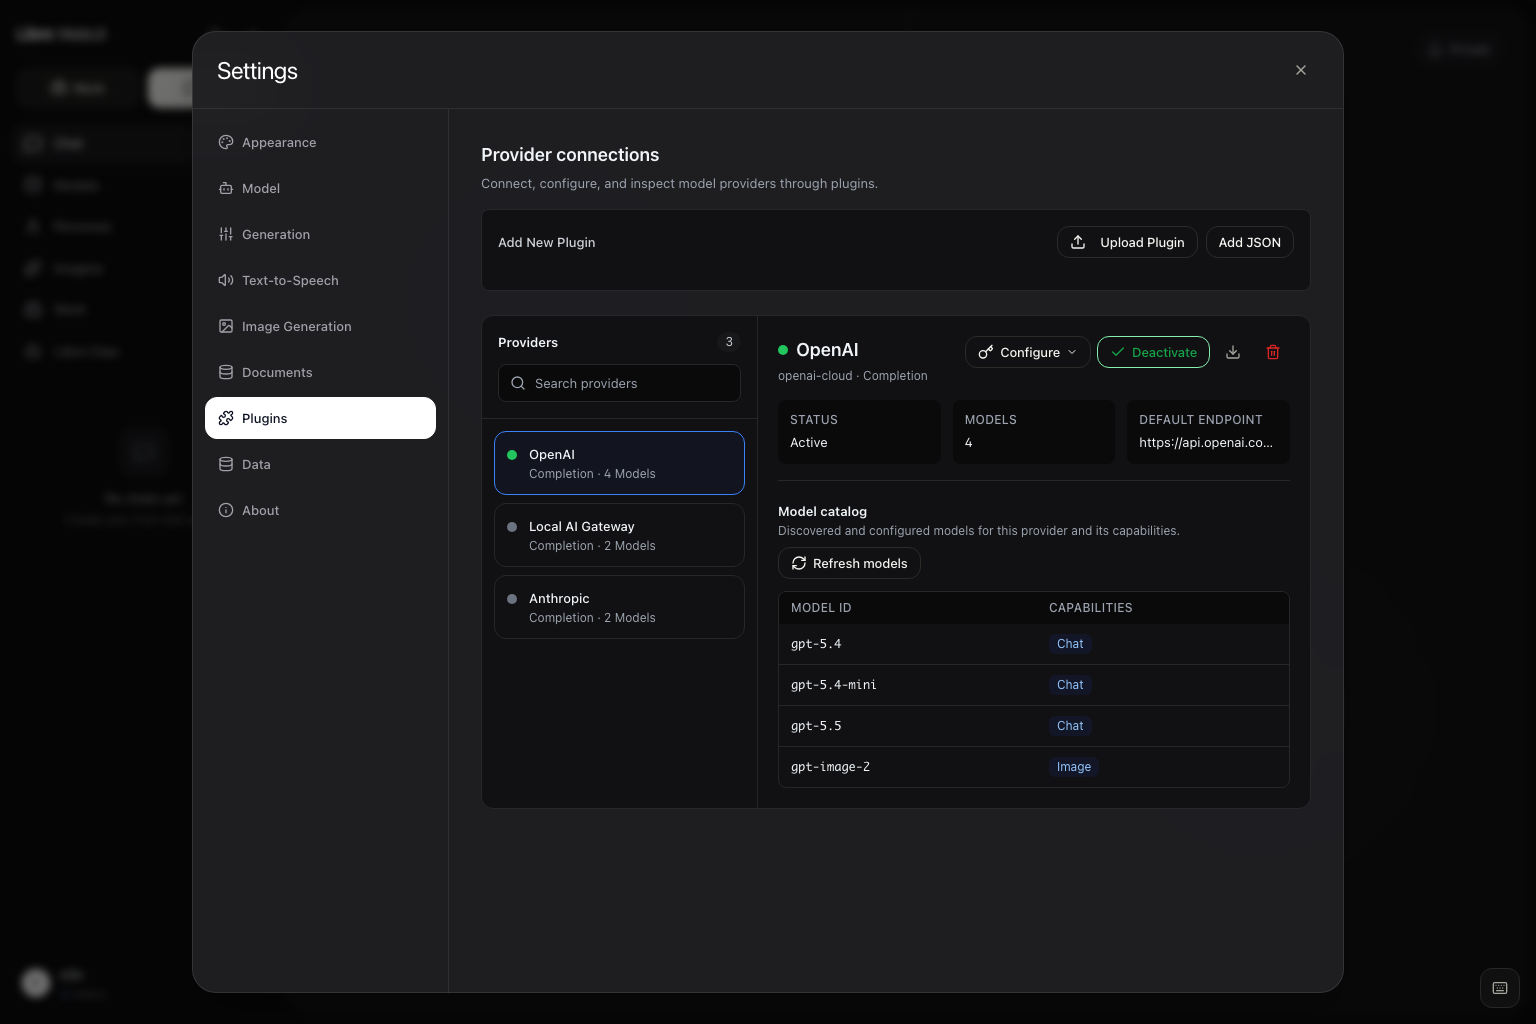
Libre WebUI obsługuje formaty komunikacji:
- OpenAI Chat Completions;
- OpenAI Responses;
- Anthropic Messages; oraz
- treści i wywołania funkcji Google Gemini.
Dołączone Anthropic i Gemini używają specjalnych adapterów wybranych przez tożsamość dostawcy. Nowo importowany dostawca używa semantyki OpenAI Chat Completions albo Responses; wskazanie API zgodnego z Anthropic/Gemini nie wybiera tych adapterów. Inny kształt żądania, strumienia, narzędzia lub odpowiedzi wymaga adaptera zaplecza. JSON opisuje routing i konfigurację, nie tłumaczy obcego protokołu.
Otwieranie Połączeń dostawców
- Zaloguj się i otwórz Ustawienia > Wtyczki.
- Wyszukaj dostawcę na liście po lewej.
- Wybierz go, aby sprawdzić aktywność i efektywny katalog.
- Aktywuj dla swojego konta.
- Wybierz Konfiguruj tylko, gdy zapisujesz poświadczenie lub zastępujesz ustawienie.
Konfiguracja jest domyślnie zamknięta. Ustawienia połączenia są pierwsze dla administratorów, a parametry próbkowania w osobno zwiniętej sekcji Parametry zaawansowane. Dziedziczone wartości są wskazówkami, nie wstępnie wpisanymi nadpisaniami konta.
Definicje wtyczek są wspólną konfiguracją instancji, więc tylko administratorzy je importują, instalują, aktualizują i usuwają. Użytkownik kontroluje własną aktywację, poświadczenie i dozwolone ustawienia generowania.
Szybkie dodanie połączenia
Ustawienia > Połączenia to krótsza droga dla jednego punktu zgodnego z OpenAI i klucza API. Administrator widzi kartę lokalnego Ollama ze stanem i wersją, listę połączeń i formularz.
Dodanie wymaga nazwy, pełnego URL chat completions i opcjonalnego klucza. Libre WebUI wyprowadza ID z nazwy, instaluje definicję, zapisuje klucz na serwerze, aktywuje i pyta o modele. Wykryte modele zastępują katalog tymczasowy i pojawiają się w selektorze.
Wiersz pokazuje punkt, liczbę modeli, zapis klucza, aktywność, odświeżenie i usunięcie. Tryby Responses, nadpisania bazowego URL, katalogi per możliwość i polityka parametrów pozostają w pełnym Ustawienia > Wtyczki.
Codex (logowanie ChatGPT)
Dołączony Codex (ChatGPT) nie wymaga klucza API. Gdy serwer ma logowanie Codex CLI (codex login jako użytkownik systemu serwera), dostawca pojawia się administratorom i oferuje przez sesję ChatGPT modele GPT-6 Astra, GPT-6.1 Sol (gpt-6.1-sol), GPT-6.1 Terra (gpt-6.1-terra), GPT-6 Sol, GPT-6 Luna, GPT-5.6 Sol, Terra, Luna, GPT-5.5 i GPT-5.3 Codex Spark, zależnie od dostępu zalogowanego konta. Tokeny są czytane z auth.json CLI, odświeżane tym samym klientem OAuth i zapisywane z powrotem; wartości nie pojawiają się w logach.
Żądania pochodzą z zaplecza, nigdy kontenera zadania, więc modele obsługują Work z normalną pętlą narzędzi. Dostawca jest tylko dla administratorów, bo każde wywołanie zużywa subskrypcję ChatGPT właściciela serwera. Ukryj go przez CODEX_OAUTH_MODELS_ENABLED=false lub wskaż inne logowanie przez CODEX_HOME.
Amazon Bedrock
Dołączony dostawca Amazon Bedrock przyjmuje klucz API Bedrock, krótko- lub długoterminowy, z
konsoli Amazon Bedrock. Zapisz go w ustawieniach dostawcy albo ustaw AWS_BEARER_TOKEN_BEDROCK na
serwerze. Nie potrzeba AWS SDK, pary kluczy dostępu ani podpisywania IAM.
Libre WebUI łączy się z punktem końcowym bedrock-mantle.<region>.api.aws danego Region i wyświetla
każdy model, który konto może tam wywołać, tak jak OpenRouter wyświetla swój katalog. Modele, których
konto nie może jeszcze używać, na przykład z powodu trybu retencji danych, są pomijane na liście.
Wybierz Region w ustawieniu Region. Przełącza ono tylko między hostami Bedrock, więc klucz nigdy
nie może zostać wysłany gdzie indziej, a jego zmiana zachowuje zapisany klucz.
Modele Claude (anthropic.*) działają przez Anthropic Messages API Bedrock, więc myślenie,
narzędzia i limity tokenów zachowują się tak jak u dostawcy Anthropic. Każdy inny model używa Chat
Completions. Bedrock udostępnia niektóre rodziny na drugiej trasie Chat Completions; Libre WebUI
próbuje tej trasy, gdy Bedrock zgłasza, że model się tam znajduje, i zapamiętuje to. Czat, Work i
silnik Strands mogą używać wszystkich tych modeli, a użycie pojawia się w analityce pod dostawcą.
W komercyjnych Regionach AWS udostępnia Claude Haiku 5.5 i Claude Sonnet 5.5 tylko na
bedrock-runtime, przez międzyregionalne profile inferencji, więc lista modeli Mantle nigdy ich nie
zawiera. Katalog dodaje global.anthropic.claude-haiku-5-5 i
global.anthropic.claude-sonnet-5-5, a każdy identyfikator profilu inferencji Claude (global.,
us., eu., au. lub jp.) jest wysyłany z tym samym kluczem API do
bedrock-runtime.<region>.amazonaws.com/anthropic/v1/messages wybranego Regionu. Klucz nadal trafia
tylko do dwóch hostów Bedrock tego Regionu. Twoje konto nadal potrzebuje dostępu do modelu w
Amazon Bedrock.
Modal
Dołączony dostawca Modal wywołuje współdzielony router inferencji Modal,
https://inference.us-west.modal.direct/v1, przez Chat Completions. Dociera do Shared Endpoints w
Twoim workspace Modal, za które Modal nalicza opłaty za token.
- Utwórz Shared Endpoint dla każdego potrzebnego modelu, na karcie Endpoints w panelu Modal
albo poleceniem
modal endpoint create --shared --model moonshotai/Kimi-K3. - Utwórz token proxy w ustawieniach panelu Modal albo poleceniem
modal workspace proxy-tokens create. - Połącz identyfikator tokena i sekret kropką,
wk-<id>.ws-<secret>, i zapisz wynik jako klucz API dostawcy albo ustawMODAL_PROXY_TOKENna serwerze.
Libre WebUI wyświetla następnie każdy punkt końcowy, do którego token ma dostęp, z /v1/models
routera, wraz z oknem kontekstu i informacją, czy model rozumuje. Router zna model wyłącznie po
nazwie hosta jego punktu końcowego, np.
acme--ep-muse-spark-open-816b-a42b-server.us-west.modal.direct, więc właśnie ten identyfikator
modelu wysyła Libre WebUI; selektor modeli pokazuje go pod nazwą punktu końcowego, tutaj
"Muse Spark Open 816B A42B". Model bez punktu końcowego w Twoim workspace odpowiada
unknown inference model.
Każde żądanie jednej rozmowy niesie ten sam Modal-Routing-Affinity-Key, wyprowadzony z modelu i
pierwszej wiadomości rozmowy, więc Modal kieruje je do kontenera, który ma już prompt rozmowy w
swojej pamięci podręcznej. Work robi to samo dla każdego kroku pętli agenta w przebiegu. Tokeny
wejściowe z pamięci podręcznej kosztują ułamek zwykłej stawki. Gdy kompaktowanie przepisuje
historię, klucz się zmienia, zgodnie z zaleceniem Modal.
Aby wywołać jeden punkt końcowy bezpośrednio, ustaw Pełny URL punktu końcowego API dostawcy na jego URL
(modal endpoint info <name> pokazuje go jako service_url) z dopisanym /v1/chat/completions.
W ten sposób łączy się z Dedicated Endpoint; tam model zachowuje swoją nazwę z Hugging Face, np.
moonshotai/Kimi-K3, i tak też dołączona lista nazywa współdzielone modele Modal, zanim zostanie
zapisany token. Shared Endpoints ograniczają liczbę równoczesnych żądań na model i powyżej limitu
odpowiadają 429.
OpenCode w Work może używać tego samego tokena. Gdy na serwerze ustawiono MODAL_PROXY_TOKEN albo
zapisano logowanie Modal przez opencode auth login, model modal/… działa w piaskownicy, a token
jest wysyłany wyłącznie do inference.us-west.modal.direct.
Baseten
Dołączony dostawca Baseten wywołuje Model APIs Baseten, https://inference.baseten.co/v1, przez
Chat Completions. Baseten hostuje modele i nalicza opłaty za token, więc niczego nie trzeba
najpierw wdrażać.
- Utwórz osobisty klucz API w panelu Baseten w Settings > API keys.
- Zapisz go jako klucz API dostawcy albo ustaw
BASETEN_API_KEYna serwerze.
Libre WebUI wyświetla następnie katalog Model APIs z /v1/models, wraz z oknem kontekstu każdego
modelu i informacją, czy rozumuje. Modele decyzyjne Baseten (decision-models/…) odpowiadają
tylko przez System One API Baseten, dlatego są wyświetlane jako modele decyzyjne, a nie jako modele
czatu; zobacz Modele decyzyjne. Modele zachowują slugi
Baseten, np. zai-org/GLM-5.3 lub moonshotai/Kimi-K3; selektor pokazuje je jako "GLM 5.3" od
Z.ai i "Kimi K3" od Moonshot AI. Wariant Fast uruchamia te same wagi na dedykowanej mocy
obliczeniowej po własnej cenie.
Większość tych modeli domyślnie rozumuje. Kontrolka myślenia w czacie ustawia reasoning_effort
Baseten: Niski i Wysoki są wysyłane bez zmian, środkowe ustawienie zostawia modelowi jego
własną domyślną głębokość, a Wyłączone wysyła none. Bardzo wysoki wysyła high,
ponieważ modele Baseten nie zgadzają się co do poziomu powyżej: niektóre przyjmują xhigh,
niektóre tylko max, a niektóre nie przyjmują żadnego z nich. Baseten dokumentuje kilka
wyjątków: Muse Spark Open i Beam zawsze rozumują, a GLM 5.3 z none nadal lekko rozumuje.
Wcześniejsze rozumowanie jest odsyłane jako reasoning_content, którego Beam wymaga przy każdej
wcześniejszej odpowiedzi.
Każde żądanie jednej rozmowy niesie ten sam klucz x-session-affinity, wyprowadzony z modelu i
pierwszej wiadomości rozmowy, więc Baseten kieruje je do repliki, która ma już prompt rozmowy w
swojej pamięci podręcznej. Work robi to samo dla każdego kroku pętli agenta w przebiegu. Gdy
kompaktowanie przepisuje historię, klucz się zmienia.
Aby zamiast tego wywołać dedykowane wdrożenie, ustaw Pełny URL punktu końcowego API dostawcy na
https://model-<model id>.api.baseten.co/environments/production/sync/v1/chat/completions.
Ten sam klucz API działa również tam.
OpenCode w Work może używać tego samego klucza. Gdy na serwerze ustawiono BASETEN_API_KEY albo
zapisano logowanie Baseten przez opencode auth login, model baseten/… działa w piaskownicy, a
klucz jest wysyłany wyłącznie do inference.baseten.co.
Wybór dostawcy dołączonego lub importowanego
Libre WebUI zawiera OpenAI, Anthropic, Gemini, Groq, Mistral, DeepSeek, Meta, Modal, Baseten, Amazon Bedrock, OpenRouter, Kimi Code Moonshot AI, Hugging Face, GitHub Models, lokalny MLX LM i inne usługi. Zacznij od dołączonej pozycji, gdy protokół i uwierzytelnianie pasują.
Administrator może importować JSON dla innej zgodnej usługi. Minimalna brama zgodna z OpenAI:
{
  "id": "private-ai-gateway",
  "name": "Private AI Gateway",
  "type": "completion",
  "endpoint": "http://ai-gateway:8080/v1/chat/completions",
  "api_mode": "chat_completions",
  "auth": {
    "header": "Authorization",
    "prefix": "Bearer ",
    "key_env": "PRIVATE_AI_GATEWAY_API_KEY"
  },
  "model_map": ["gateway-chat"]
}
Importuj w Ustawienia > Wtyczki, aktywuj i zapisz klucz dla konta. Dodaj zmienne połączenia, gdy administratorzy mają edytować bazowy URL, ścieżkę, wykrywanie lub punkty per możliwość. Pełny przykład: plugins/openai.json.
Dla celowo nieuwierzytelnionej bramy w zaufanej sieci ustaw auth.header i auth.key_env jako puste ciągi i pomiń auth.prefix. Libre nie wymaga ani nie wysyła klucza.
Chat Completions lub Responses
Wtyczki zgodne z OpenAI obsługują dwa tryby:
| Tryb API | Domyślna ścieżka | Typowe pole |
|---|---|---|
chat_completions | /chat/completions | messages |
responses | /responses | input |
Dołączony OpenAI udostępnia Tryb API. Libre mapuje gotowe i strumieniowe Responses do Chat i Work, w tym ograniczony stan odtwarzania rozumowania i narzędzi.
Zmiana trybu wpływa na domyślną ścieżkę, nie protokół upstream. Wybierz Responses tylko przy zgodnych kształtach żądań i zdarzeń.
Bazowy URL lub pełny punkt końcowy
Trasa jest rozwiązywana kolejno:
- Niedomyślne pełne nadpisanie
endpoint. base_urli opcjonalneapi_path.- Punkt z definicji.
Bazowy URL korzenia API:
https://gateway.example/v1
Chat Completions bez ścieżki wysyła do:
https://gateway.example/v1/chat/completions
Responses do:
https://gateway.example/v1/responses
Użyj Ścieżki API dla zgodnej operacji względnej. Starszy pełny punkt tylko dla kompletnego URL; pełny ma pierwszeństwo.
Znane przyrostki /chat/completions, /completions, /responses też określają semantykę. Nieznana ścieżka zachowuje jawny tryb.
Po zmianie trasy lub klucza zapisz dostawcę przed testem. Trasa niestandardowa wymagająca uwierzytelniania potrzebuje poświadczenia tego samego konta. Wtyczka bez uwierzytelniania zostawia pola puste. Libre WebUI nie wysyła zarządzanego klucza środowiskowego do celu użytkownika; fallback środowiska jest tylko dla zaufanej trasy dołączonej.
Wykrywanie i utrzymywanie identyfikatorów modeli
Wybierz aktywnego dostawcę czatu i Odśwież modele. Libre przeładuje jego katalog i listę Chat.
Wykrywanie działa też automatycznie, gdy katalogu brak lub jest starszy niż PLUGIN_MODEL_DISCOVERY_TTL_MS. Odśwież modele wymusza kontrolę:
| Wynik | Znaczenie |
|---|---|
| Katalog zaktualizowany | Dostawca odpowiedział inną listą |
| Katalog jest aktualny | Dostawca zwrócił tę samą listę |
| Potrzebny klucz API | Brak klucza, brak żądania; stary katalog pozostaje |
| Nie można wczytać katalogu | Dostawca nieosiągalny lub brak użytecznych danych |
Klucz tylko w środowisku nie jest używany dla zainstalowanej zamiast dołączonej definicji; komunikat to wyjaśnia. Modele mowy, obrazów i osadzania są tu widoczne z etykietami, ale nie trafiają do selektora czatu.
Dla trasy zgodnej z OpenAI URL modeli jest wybierany tak:
- trasa kończąca się
/modelsbez zmian; - znany przyrostek
/chat/completions,/completions,/responses,/embeddingslub/messageszastąpiony/models; albo - dołączone
/models.
Obie trasy dają ten sam URL:
https://gateway.example/v1/chat/completions
https://gateway.example/v1/responses

-> https://gateway.example/v1/models
Gdy wyprowadzenie jest niewłaściwe, wystaw models_endpoint w variables:
{
  "name": "models_endpoint",
  "type": "string",
  "label": "Models Endpoint",
  "default": "https://gateway.example/v1/models"
}
Wartość dziedziczona lub zapisana przez administratora ma pierwszeństwo. Właściwość najwyższego poziomu models_endpoint nie jest czytana. Odpowiedź ma mieć obiekty w data:
{
  "data": [{ "id": "gateway-chat" }, { "id": "gateway-code" }]
}
Wykryte ID są per użytkownik i nie zmieniają pliku. Bez zgodnego wykrywania utrzymuj model_map. Katalog jest tylko do odczytu; etykiety mówią, która trasa wymienia model, nie sprawdzają zdrowia.
ID nie są globalnie unikatowe. Chat zapisuje surowe ID z dokładną tożsamością Ollama lub wtyczki, więc nazwy mogą się powtarzać. Niedostępny zapisany dostawca jest oznaczany jako niedostępny, nie zastępowany.
Oddzielna konfiguracja obrazów
Dołączony OpenAI używa https://api.openai.com/v1/images/generations i domyślnie gpt-image-2 dla nowych konfiguracji. Starsze GPT Image-ID pozostają jako fallback.
Trasy czatu i obrazów są izolowane. Niestandardowy bazowy URL czatu nie dostaje obrazów. Puste image_endpoint używa definicji, a pełny URL ustawia zgodną operację Image API.
Wybór obrazów jest kwalifikowany dostawcą. Przy tym samym ID żądanie trafia tylko do wybranego w panelu.
Bezpieczna brama HTTP
Punkty mogą używać HTTP lub HTTPS. HTTP przydaje się w zaufanym LAN, Tailscale lub sieci kontenerów, ale przesyła klucze, prompty, wyniki i treść bez szyfrowania. Preferuj HTTPS poza granicą sieci lub przy TLS.
Żądania pochodzą z zaplecza, nie przeglądarki. Wybierz osiągalny adres:
| Lokalizacja zaplecza | Przykład |
|---|---|
| Proces natywny, ta sama maszyna | http://127.0.0.1:8081/v1 |
| Usługa Docker Compose | http://ai-gateway:8080/v1 |
| Kontener do obsługiwanego hosta | http://host.docker.internal:8081/v1 |
| Zaufany LAN/Tailscale | http://192.168.1.20:8081/v1 |
W kontenerze localhost oznacza kontener Libre WebUI, nie inną usługę ani hosta.
Libre przyjmuje tylko HTTP/HTTPS, sprawdza cel przed wyborem poświadczenia i nie śledzi przekierowań. Podaj końcowy URL.
Weryfikacja bramy przed aktywacją
Przetestuj wykrywanie z maszyny/kontenera zaplecza:
curl http://ai-gateway:8080/v1/models \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY'
Następnie operację trybu.
Chat Completions:
curl http://ai-gateway:8080/v1/chat/completions \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "messages": [{"role": "user", "content": "Reply with: ready"}],
    "stream": false
  }'
Responses:
curl http://ai-gateway:8080/v1/responses \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "input": "Reply with: ready",
    "store": false
  }'
Po sukcesie ustaw tę samą trasę, tryb, poświadczenie i ID. Aktywuj, odśwież, wybierz kwalifikowany model. Work może go użyć przy niezawodnych wywołaniach narzędzi.
Rozwiązywanie problemów
| Objaw | Sprawdzenie |
|---|---|
| Żądania nadal trafiają do dołączonego punktu | Usuń stare pełne nadpisanie, zapisz bazowy URL i ścieżkę. |
| Dostawca dostaje zły ładunek | Dopasuj tryb do protokołu i końcowego przyrostka. |
| Odświeżenie nie zwraca ID | Testuj /models, data[].id, ustaw models_endpoint albo utrzymuj model_map. |
| Stary model zostaje po zmianie | Zapisz zmianę; Libre czyści stary wykryty katalog przed odświeżeniem. |
| Brak klucza API | Zapisz poświadczenie per użytkownik; fallback środowiska nie podąża za nadpisaniem. |
| Docker nie osiąga localhost | Użyj nazwy usługi, aliasu hosta lub osiągalnego adresu prywatnego. |
| Czat działa, obrazy nie | Ustaw osobny pełny image_endpoint i właściwy model. |
| Czat działa, Work odrzuca | Potwierdź zgodne wywołania narzędzi; tekst nie wystarcza. |
| Dostawca przekierowuje | Ustaw końcowy sprawdzony URL; Libre nie śledzi przekierowań. |
Szczegóły routingu, poświadczeń, odtwarzania i autoryzacji: Wtyczki. Błędy wdrożenia: Rozwiązywanie problemów.
Podziękowanie społeczności
Przewodnik i środowisko Połączeń dostawców 0.16.0 powstały dzięki ZhengJin (@fangzhengjin), którego szczegółowe uwagi i wspomagana przez AI koncepcja UX w #163 pomogły zdefiniować przepływ.