Externe en zelfgehoste providers verbinden
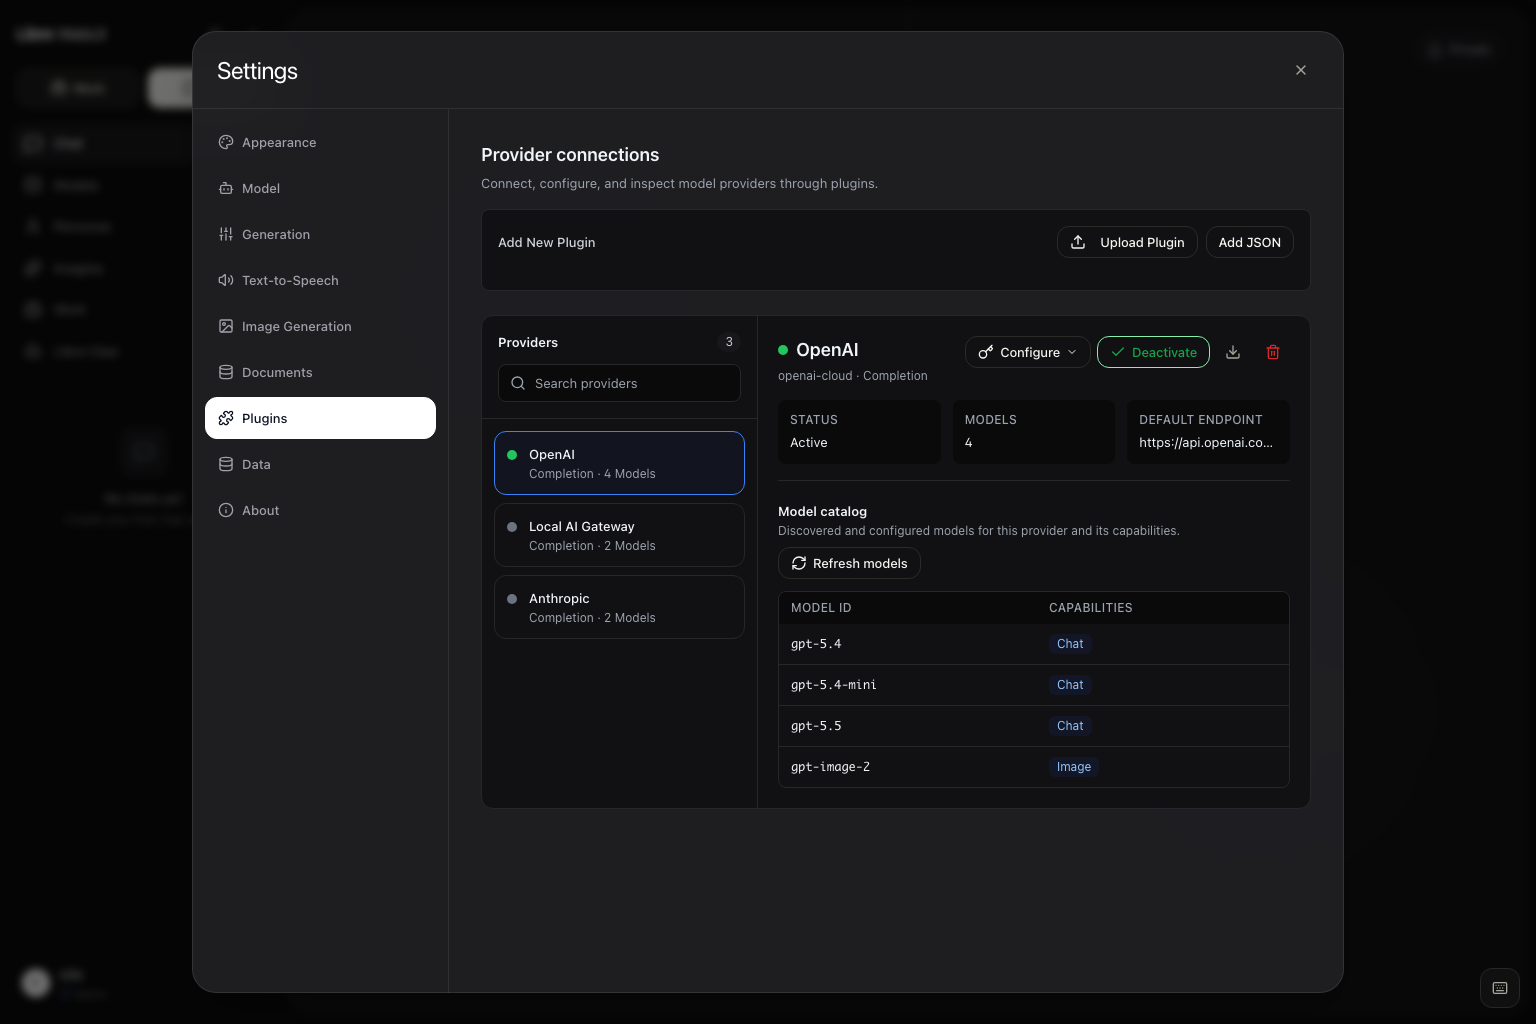
Libre WebUI 0.16.0 voegt een gerichte werkruimte Providerverbindingen toe binnen Instellingen > Plugins. Gebruik deze om een meegeleverde provider te activeren, een compatibele plugin naar een andere API te laten wijzen, de effectieve modelcatalogus te bekijken of een zelfgehoste gateway op een vertrouwd netwerk te verbinden.
Libre WebUI ondersteunt momenteel deze communicatie-indelingen van providers:
- OpenAI Chat Completions;
- OpenAI Responses;
- Anthropic Messages; en
- Google Gemini-inhoud en functieaanroepen.
De meegeleverde definities voor Anthropic en Gemini gebruiken speciale adapters die door hun provideridentiteit worden geselecteerd. Een nieuw geïmporteerde provider gebruikt de semantiek van OpenAI Chat Completions of OpenAI Responses; deze naar een Anthropic- of Gemini-compatibele API laten wijzen selecteert de meegeleverde adapters niet. Een provider met een andere vorm voor verzoeken, streaming, toolaanroepen of antwoorden heeft een backendadapter nodig. Plugin-JSON beschrijft routering en configuratie; het vertaalt geen niet-verwant protocol.
Providerverbindingen openen
- Meld je aan en open Instellingen > Plugins.
- Zoek in de providerlijst in het linkerpaneel.
- Selecteer een provider om de actieve status en effectieve modelcatalogus te bekijken.
- Activeer de provider voor je account.
- Selecteer Configureren alleen wanneer je een referentie moet opslaan of een verbindingsinstelling wilt overschrijven.
Providerconfiguratie is standaard gesloten. Verbindingsinstellingen verschijnen voor beheerders bovenaan, terwijl steekproefbediening zoals temperatuur en tokenlimieten onder het afzonderlijk ingeklapte gedeelte Geavanceerde parameters blijft. Geërfde standaardwaarden verschijnen als hints in plaats van vooraf ingevulde accountoverschrijvingen.
Plugindefinities zijn gedeelde instantieconfiguratie; alleen beheerders kunnen ze importeren, installeren, bijwerken of verwijderen. Elke geverifieerde gebruiker beheert de eigen activeringsstatus, referentie en toegestane generatie-instellingen.
Snel een verbinding toevoegen
Instellingen > Verbindingen is een kortere route voor het gebruikelijke geval: één OpenAI-compatibel eindpunt en één API-sleutel. Beheerders zien een kaart voor de lokale Ollama-runtime met status en versie, een lijst van bestaande OpenAI-compatibele verbindingen en een klein formulier om er nog een toe te voegen.
Voor een verbinding zijn een weergavenaam, de volledige URL voor chatvoltooiingen en een optionele API-sleutel nodig. Libre WebUI leidt de verbindings-ID af uit de naam, installeert de providerdefinitie, bewaart de sleutel server-side, activeert de verbinding en vraagt welke modellen het eindpunt aanbiedt. De gevonden modellen vervangen de tijdelijke catalogus en verschijnen in de chatmodelkiezer.
Elke rij toont eindpunt, modelaantal, of een sleutel is opgeslagen, een actiefschakelaar, modelvernieuwing en verwijderen. Alles wat verder gaat — Responses API-modi, overschrijvingen van de basis-URL, catalogi per mogelijkheid en beleid voor generatieparameters — blijft in de uitgebreidere werkruimte Instellingen > Plugins hierboven.
Codex (aanmelden met ChatGPT)
De meegeleverde provider Codex (ChatGPT) heeft geen API-sleutel nodig. Wanneer de server een aanmelding van de Codex CLI heeft (codex login als de besturingssysteemgebruiker van de server), verschijnt de provider voor beheerders en biedt via de ChatGPT-sessie GPT-6 Astra, GPT-6.1 Sol (gpt-6.1-sol), GPT-6.1 Terra (gpt-6.1-terra), GPT-6 Sol, GPT-6 Luna, GPT-5.6 Sol, Terra, Luna, GPT-5.5 en GPT-5.3 Codex Spark aan, afhankelijk van de modeltoegang van het aangemelde account. Toegangstokens worden uit het eigen auth.json van de CLI gelezen, vernieuwd via dezelfde OAuth-client als de CLI en teruggeschreven zodat de CLI blijft werken; tokenwaarden verschijnen nooit in logs.
Omdat verzoeken door de backend worden gedaan — nooit vanuit een taakcontainer — kunnen deze modellen ook Work aandrijven via de normale toolcyclus in de sandbox. De provider is alleen voor beheerders, omdat elke aanroep het ChatGPT-abonnement van de servereigenaar gebruikt. Verberg de provider volledig met CODEX_OAUTH_MODELS_ENABLED=false of wijs met CODEX_HOME naar een andere aanmelding.
Amazon Bedrock
De meegeleverde provider Amazon Bedrock gebruikt een Bedrock-API-sleutel, kortlopend of
langlopend, uit de Amazon Bedrock-console. Sla hem op in de instellingen van de provider of stel
AWS_BEARER_TOKEN_BEDROCK in op de server. Er is geen AWS SDK, sleutelpaar of IAM-ondertekening nodig.
Libre WebUI communiceert met het eindpunt bedrock-mantle.<region>.api.aws van de Region en toont
elk model dat het account daar kan aanroepen, op dezelfde manier als OpenRouter zijn catalogus toont.
Modellen die het account nog niet kan gebruiken, bijvoorbeeld vanwege de modus voor gegevensretentie,
blijven uit de lijst. Kies de Region met de instelling Region. Ze schakelt alleen tussen
Bedrock-hosts, zodat de sleutel nooit ergens anders naartoe kan worden gestuurd, en het wijzigen ervan
behoudt de opgeslagen sleutel.
Claude-modellen (anthropic.*) lopen via de Anthropic Messages API van Bedrock, dus nadenken, tools
en tokenlimieten gedragen zich zoals bij de Anthropic-provider. Elk ander model gebruikt Chat
Completions. Bedrock levert sommige families via een tweede Chat Completions-route; Libre WebUI
probeert die route wanneer Bedrock meldt dat een model daar staat, en onthoudt dat. Chat, Work en de
Strands-engine kunnen al deze modellen gebruiken, en het gebruik verschijnt onder de provider in de analyses.
In commerciële Regions levert AWS Claude Haiku 5.5 en Claude Sonnet 5.5 alleen via
bedrock-runtime, met cross-Region-inferentieprofielen, zodat de modellijst van Mantle ze nooit
bevat. De catalogus voegt global.anthropic.claude-haiku-5-5 en
global.anthropic.claude-sonnet-5-5 toe, en elke Claude-inferentieprofiel-ID (global., us.,
eu., au. of jp.) wordt met dezelfde API-sleutel verzonden naar
bedrock-runtime.<region>.amazonaws.com/anthropic/v1/messages van de geselecteerde Region. De
sleutel gaat nog steeds alleen naar de twee Bedrock-hosts van die Region. Uw account heeft nog
steeds toegang tot het model in Amazon Bedrock nodig.
Modal
De meegeleverde provider Modal roept de gedeelde inferentierouter van Modal aan,
https://inference.us-west.modal.direct/v1, met Chat Completions. Hij bereikt de Shared Endpoints
in uw Modal-workspace, die Modal per token factureert.
- Maak voor elk gewenst model een Shared Endpoint aan, via het tabblad Endpoints in het
Modal-dashboard of met
modal endpoint create --shared --model moonshotai/Kimi-K3. - Maak een proxytoken aan in de instellingen van het Modal-dashboard of met
modal workspace proxy-tokens create. - Voeg de token-ID en het geheim samen met een punt,
wk-<id>.ws-<secret>, en sla het resultaat op als API-sleutel van de provider, of stelMODAL_PROXY_TOKENin op de server.
Libre WebUI toont daarna elk eindpunt dat het token kan bereiken via /v1/models van de router, met
het contextvenster en of het model redeneert. De router kent een model alleen aan de hostnaam van
zijn eindpunt, zoals
acme--ep-muse-spark-open-816b-a42b-server.us-west.modal.direct, dus dat is de model-ID die
Libre WebUI verstuurt; de modelkiezer toont het met de naam van het eindpunt, hier
"Muse Spark Open 816B A42B". Een model zonder eindpunt in uw workspace antwoordt
unknown inference model.
Elk verzoek binnen één gesprek draagt dezelfde Modal-Routing-Affinity-Key, afgeleid van het model
en het eerste bericht van het gesprek, zodat Modal het naar de container stuurt die de prompt van
het gesprek al in zijn cache heeft. Work doet hetzelfde voor elke stap van de agentlus van een run.
Gecachete invoertokens kosten een fractie van het normale tarief. Wanneer compaction de
geschiedenis herschrijft, verandert de sleutel, zoals Modal aanbeveelt.
Om één eindpunt rechtstreeks aan te roepen, stelt u de Volledige API-eindpunt-URL van de provider in op de
URL ervan (modal endpoint info <name> toont die als service_url), gevolgd door
/v1/chat/completions. Zo bereikt u een Dedicated Endpoint; daar behoudt het model zijn Hugging
Face-naam, zoals moonshotai/Kimi-K3, en zo noemt de meegeleverde lijst de gedeelde modellen van
Modal ook zolang er nog geen token is opgeslagen. Shared Endpoints beperken het aantal
gelijktijdige verzoeken per model en antwoorden 429 boven die limiet.
OpenCode in Work kan hetzelfde token gebruiken. Met MODAL_PROXY_TOKEN ingesteld op de server, of
een Modal-aanmelding opgeslagen met opencode auth login, draait een modal/…-model in de sandbox
en wordt het token uitsluitend naar inference.us-west.modal.direct verstuurd.
Baseten
De meegeleverde provider Baseten roept de Model APIs van Baseten aan,
https://inference.baseten.co/v1, met Chat Completions. Baseten host de modellen en factureert per
token, dus u hoeft vooraf niets te deployen.
- Maak een persoonlijke API-sleutel aan in het Baseten-dashboard onder Settings > API keys.
- Sla die op als API-sleutel van de provider, of stel
BASETEN_API_KEYin op de server.
Libre WebUI toont daarna de Model APIs-catalogus van /v1/models, met het contextvenster van elk
model en of het redeneert. De beslismodellen van Baseten (decision-models/…) beantwoorden
alleen de System One API van Baseten en staan daarom als beslismodellen in de lijst in plaats van
als chatmodellen; zie Beslismodellen. Modellen
behouden de slugs van Baseten, zoals zai-org/GLM-5.3 of moonshotai/Kimi-K3; de kiezer toont ze
als "GLM 5.3" van Z.ai en "Kimi K3" van Moonshot AI. Een Fast-variant draait dezelfde gewichten
op toegewezen capaciteit tegen een eigen prijs.
De meeste van deze modellen redeneren standaard. De nadenkinstelling in de chat bepaalt
reasoning_effort van Baseten: Laag en Hoog worden ongewijzigd verstuurd, de middelste
stand laat het model op zijn eigen standaarddiepte en Uit verstuurt none. Zeer hoog
verstuurt high, omdat de modellen van Baseten het niet eens zijn over het niveau daarboven:
sommige accepteren xhigh, sommige alleen max en sommige geen van beide. Baseten documenteert
enkele uitzonderingen: Muse Spark Open en Beam redeneren altijd, en GLM 5.3 redeneert met none
nog licht. Eerdere redeneringen worden teruggestuurd als reasoning_content, wat Beam bij elk
eerder antwoord vereist.
Elk verzoek binnen één gesprek draagt dezelfde x-session-affinity-sleutel, afgeleid van het model
en het eerste bericht van het gesprek, zodat Baseten het naar de replica stuurt die de prompt van
het gesprek al in zijn cache heeft. Work doet hetzelfde voor elke stap van de agentlus van een run.
Wanneer compaction de geschiedenis herschrijft, verandert de sleutel.
Om in plaats daarvan een toegewezen deployment aan te roepen, stelt u de Volledige API-eindpunt-URL van de
provider in op
https://model-<model id>.api.baseten.co/environments/production/sync/v1/chat/completions.
Dezelfde API-sleutel werkt daar.
OpenCode in Work kan dezelfde sleutel gebruiken. Met BASETEN_API_KEY ingesteld op de server, of
een Baseten-aanmelding opgeslagen met opencode auth login, draait een baseten/…-model in de
sandbox en wordt de sleutel uitsluitend naar inference.baseten.co verstuurd.
Een meegeleverde of geïmporteerde provider kiezen
Libre WebUI bevat definities voor OpenAI, Anthropic, Gemini, Groq, Mistral, DeepSeek, Meta, Modal, Baseten, Amazon Bedrock, OpenRouter, Kimi Code van Moonshot AI, Hugging Face, GitHub Models, lokale MLX LM en andere model- of mediadiensten. Begin met een meegeleverde vermelding wanneer protocol en verificatiecontract bij de gewenste dienst passen.
Voor een andere compatibele dienst kan een beheerder een JSON-plugindefinitie importeren. Dit minimale voorbeeld beschrijft een OpenAI-compatibele gateway:
{
  "id": "private-ai-gateway",
  "name": "Private AI Gateway",
  "type": "completion",
  "endpoint": "http://ai-gateway:8080/v1/chat/completions",
  "api_mode": "chat_completions",
  "auth": {
    "header": "Authorization",
    "prefix": "Bearer ",
    "key_env": "PRIVATE_AI_GATEWAY_API_KEY"
  },
  "model_map": ["gateway-chat"]
}
Importeer het bestand via Instellingen > Plugins, activeer het en sla de API-sleutel op voor het account dat de verbinding gebruikt. Voeg verbindingsvariabelen aan de definitie toe wanneer beheerders Basis-URL, pad, detectie of eindpuntvelden per mogelijkheid moeten kunnen bewerken. Het meegeleverde plugins/openai.json is een volledig voorbeeld.
Stel voor een bewust verificatieloze gateway op een vertrouwd netwerk zowel auth.header als auth.key_env in op lege tekenreeksen en laat auth.prefix weg. Libre WebUI vereist of verzendt dan geen API-sleutel voor die plugin.
Chat Completions of Responses kiezen
OpenAI-compatibele voltooiingsplugins kunnen beide API-modi gebruiken:
| API-modus | Standaard verzoekpad | Gebruikelijk verzoekveld |
|---|---|---|
chat_completions | /chat/completions | messages |
responses | /responses | input |
De meegeleverde OpenAI-provider biedt API-modus in de configuratie. Libre WebUI brengt voltooide en gestreamde Responses-uitvoer terug naar Chat en Work, inclusief begrensde herhalingsstatus voor redenering en toolaanroepen.
De modus wijzigen beïnvloedt het standaard bewerkingspad. Het verandert niet het protocol van de upstreamserver; selecteer Responses alleen wanneer die server compatibele vormen voor Responses-verzoeken en -gebeurtenissen implementeert.
Een basis-URL of volledig eindpunt configureren
Libre WebUI bepaalt een voltooiingsroute in deze volgorde:
- Een niet-standaard overschrijving van het volledige
endpoint. base_urlplus een optioneelapi_path.- Het eindpunt uit de plugindefinitie.
Gebruik Basis-URL voor de API-root:
https://gateway.example/v1
Zonder aangepast pad stuurt Chat Completions verzoeken naar:
https://gateway.example/v1/chat/completions
Responses stuurt ze in plaats daarvan naar:
https://gateway.example/v1/responses
Gebruik API-pad wanneer de provider een compatibele bewerking op een ander relatief pad aanbiedt. Gebruik Ouder volledig eindpunt alleen wanneer je de volledige bewerkings-URL moet leveren; een echt volledig eindpunt heeft voorrang op Basis-URL en API-pad.
Bekende achtervoegsels /chat/completions, /completions en /responses bepalen ook de verzoeksemantiek. Een aangepast, onbekend bewerkingspad behoudt de expliciet geselecteerde API-modus.
Sla de provider na een route- of API-sleutelwijziging opnieuw op voordat je Chat test. Wanneer de plugin verificatie declareert, vereist een aangepaste verbindingsroute een referentie die door hetzelfde account is opgeslagen. Een bewust verificatieloze plugin kan beide verificatievelden leeg laten. Libre WebUI stuurt geen door de operator beheerde omgevingssleutel naar een door de gebruiker bepaalde bestemming; terugvallen op de omgeving is voorbehouden aan de vertrouwde meegeleverde route.
Model-ID's detecteren of beheren
Selecteer een actieve chatprovider en gebruik Modellen vernieuwen om detectie uit te voeren. Libre WebUI laadt zowel de catalogus van de geselecteerde provider als de modellijst van Chat opnieuw.
Detectie gebeurt ook automatisch: de catalogus van een actieve provider wordt opnieuw ontdekt wanneer deze ontbreekt of ouder is dan PLUGIN_MODEL_DISCOVERY_TTL_MS, zodat zichtbare modellen de provider volgen in plaats van het activeringsmoment. Modellen vernieuwen forceert direct een controle en meldt de uitkomst:
| Resultaat | Betekenis |
|---|---|
| Catalogus bijgewerkt | De provider antwoordde en de modellijst verschilt van de opgeslagen lijst |
| Catalogus is al actueel | De provider antwoordde met dezelfde lijst |
| API-sleutel nodig | Geen bruikbare sleutel, dus geen verzoek gedaan; de vorige catalogus blijft zichtbaar |
| Catalogus kon niet worden geladen | De provider was onbereikbaar of retourneerde niets bruikbaars |
Een sleutel die alleen in de omgeving staat, wordt niet gebruikt voor een provider die een geïnstalleerde definitie uitvoert in plaats van de meegeleverde. Het bericht zegt dit wanneer dat van toepassing is. Spraak-, afbeeldings- en embeddingmodellen in de providercatalogus worden hier met hun functielabels vermeld, maar blijven uit de chatmodelkiezer.
Voor een OpenAI-compatibele route kiest detectie de URL van de modellijst als volgt:
- een route die op
/modelseindigt, wordt ongewijzigd gebruikt; - een bekend bewerkingsachtervoegsel zoals
/chat/completions,/completions,/responses,/embeddingsof/messageswordt vervangen door/models; en - anders wordt
/modelsaan de route toegevoegd.
Beide voltooiingsroutes hieronder leiden bijvoorbeeld tot dezelfde detectie-URL:
https://gateway.example/v1/chat/completions
https://gateway.example/v1/responses

-> https://gateway.example/v1/models
Als afleiding niet de juiste volledige URL oplevert, bied models_endpoint dan aan in de array variables van de plugin:
{
  "name": "models_endpoint",
  "type": "string",
  "label": "Models Endpoint",
  "default": "https://gateway.example/v1/models"
}
De geërfde standaardwaarde of door de beheerder opgeslagen waarde heeft voorrang op het afgeleide adres. Een manifestproperty models_endpoint op het hoogste niveau wordt niet gelezen. Detectie verwacht een OpenAI-compatibel antwoord met modelobjecten in een array data:
{
  "data": [{ "id": "gateway-chat" }, { "id": "gateway-code" }]
}
Gevonden ID's worden per gebruiker opgeslagen en herschrijven het gedeelde pluginbestand niet. Als de provider geen compatibele detectie ondersteunt, onderhoud dan terugval-ID's in model_map in het plugin-JSON. De catalogus in Providerverbindingen is alleen-lezen; functielabels beschrijven welke pluginroute een model vermeldt en zijn geen gezondheidscontroles.
Model-ID's zijn niet wereldwijd uniek. Chat bewaart de onbewerkte model-ID samen met de exacte Ollama- of pluginprovideridentiteit, zodat een Ollama-model en meerdere plugins veilig dezelfde naam kunnen aanbieden. Als de opgeslagen provider niet meer beschikbaar is, toont Libre WebUI de selectie als niet beschikbaar in plaats van het verzoek stil naar een andere provider te routeren.
Afbeeldingen genereren afzonderlijk configureren
De meegeleverde OpenAI-provider biedt beeldgeneratie via https://api.openai.com/v1/images/generations en gebruikt voor nieuwe configuraties momenteel standaard gpt-image-2. Oudere GPT Image-ID's blijven in de terugvalcatalogus voor compatibele bestaande implementaties.
Chat- en afbeeldingsroutes zijn bewust geïsoleerd. Een aangepaste Basis-URL voor Chat ontvangt niet automatisch afbeeldingsverzoeken. Laat image_endpoint leeg om het afbeeldingeindpunt uit de plugin te gebruiken, of stel het in op de volledige compatibele bewerkings-URL van de Image API wanneer je provider die biedt.
Afbeeldingskeuzes zijn net als Chat-keuzes per provider gekwalificeerd. Als twee actieve plugins dezelfde afbeeldingsmodel-ID aanbieden, stuurt Libre WebUI het verzoek alleen naar de in het afbeeldingspaneel geselecteerde provider.
Veilig verbinding maken met een HTTP-gateway
Providereindpunten mogen absolute HTTP- of HTTPS-URL's gebruiken. HTTP is nuttig voor een zelfgehoste gateway op een vertrouwd LAN, Tailscale-netwerk of privaat containernetwerk, maar verzendt API-sleutels, prompts, toolresultaten en gegenereerde inhoud zonder transportversleuteling. Geef de voorkeur aan HTTPS wanneer de route een netwerkgrens overschrijdt of de gateway TLS ondersteunt.
Verzoeken komen van de Libre WebUI-backend, niet van de browser. Kies een adres dat vanuit die backend bereikbaar is:
| Backendlocatie | Voorbeeld van providerroot |
|---|---|
| Eigen proces, dezelfde machine | http://127.0.0.1:8081/v1 |
| Docker Compose-service | http://ai-gateway:8080/v1 |
| Container naar ondersteunde host | http://host.docker.internal:8081/v1 |
| Vertrouwd LAN- of Tailscale-host | http://192.168.1.20:8081/v1 |
In een container verwijst localhost naar de Libre WebUI-container zelf. Het verwijst niet naar een andere Compose-service en bereikt niet automatisch de host.
Libre WebUI accepteert alleen HTTP- en HTTPS-provider-URL's, valideert de uiteindelijke bestemming voordat een referentie wordt gekozen en volgt geen omleidingen voor provider- of detectieverzoeken. Configureer de uiteindelijke bewerkings-URL rechtstreeks.
De gateway controleren vóór activering
Test modeldetectie vanaf de machine of container waarop de Libre WebUI-backend draait:
curl http://ai-gateway:8080/v1/models \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY'
Test daarna de bewerking die bij de geselecteerde API-modus hoort.
Chat Completions:
curl http://ai-gateway:8080/v1/chat/completions \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "messages": [{"role": "user", "content": "Reply with: ready"}],
    "stream": false
  }'
Responses:
curl http://ai-gateway:8080/v1/responses \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "input": "Reply with: ready",
    "store": false
  }'
Wanneer beide aanroepen werken, stel je in Providerverbindingen dezelfde route, modus, referentie en model-ID in. Activeer de provider, kies Modellen vernieuwen en selecteer daarna het per provider gekwalificeerde model in Chat. Work kan het ook gebruiken wanneer het model betrouwbaar toolaanroepen ondersteunt.
Problemen oplossen
| Symptoom | Controle |
|---|---|
| Verzoeken bereiken nog het meegeleverde eindpunt | Verwijder een oude overschrijving van het volledige eindpunt en sla de gewenste Basis-URL en het API-pad op. |
| De provider ontvangt de verkeerde payload | Stem API-modus af op het upstreamprotocol Chat Completions of Responses en controleer het uiteindelijke achtervoegsel. |
| Modellen vernieuwen levert geen ID's op | Test /models, controleer de vorm data[].id, bied de variabele models_endpoint aan/configureer die of onderhoud model_map. |
| Een oud model blijft na een routewijziging | Sla de wijziging op; Libre WebUI wist de verouderde ontdekte catalogus van die gebruiker vóór het vernieuwen. |
| De API-sleutel wordt als ontbrekend gemeld | Sla een referentie per gebruiker op voor de aangepaste route; terugvallen op de meegeleverde omgeving volgt overschrijvingen niet. |
| Docker kan localhost niet bereiken | Gebruik de Compose-servicenaam van de gateway, een ondersteunde hostalias of een bereikbaar privénetwerkadres. |
| Chat werkt maar beeldgeneratie niet | Configureer het afzonderlijke volledige image_endpoint en kies een model uit die afbeeldingsmogelijkheid. |
| Chat werkt maar Work weigert het model | Controleer compatibele toolaanroepen; gewone tekstvoltooiing is onvoldoende. |
| De provider retourneert een omleiding | Configureer de uiteindelijke gevalideerde URL rechtstreeks; Libre WebUI volgt bewust geen provideromleidingen. |
Lees Plugins voor details over routering, referenties, herhalingsstatus en autorisatie. Zie Problemen oplossen voor implementatiespecifieke fouten.
Erkenning van de gemeenschap
Deze handleiding en de ervaring Providerverbindingen van Libre WebUI 0.16.0 zijn mede gevormd door ZhengJin (@fangzhengjin), wiens gedetailleerde feedback over externe providers en AI-ondersteunde UX-concept in #163 hielpen de werkstroom te bepalen.