Drittanbieter und selbst gehostete Anbieter verbinden
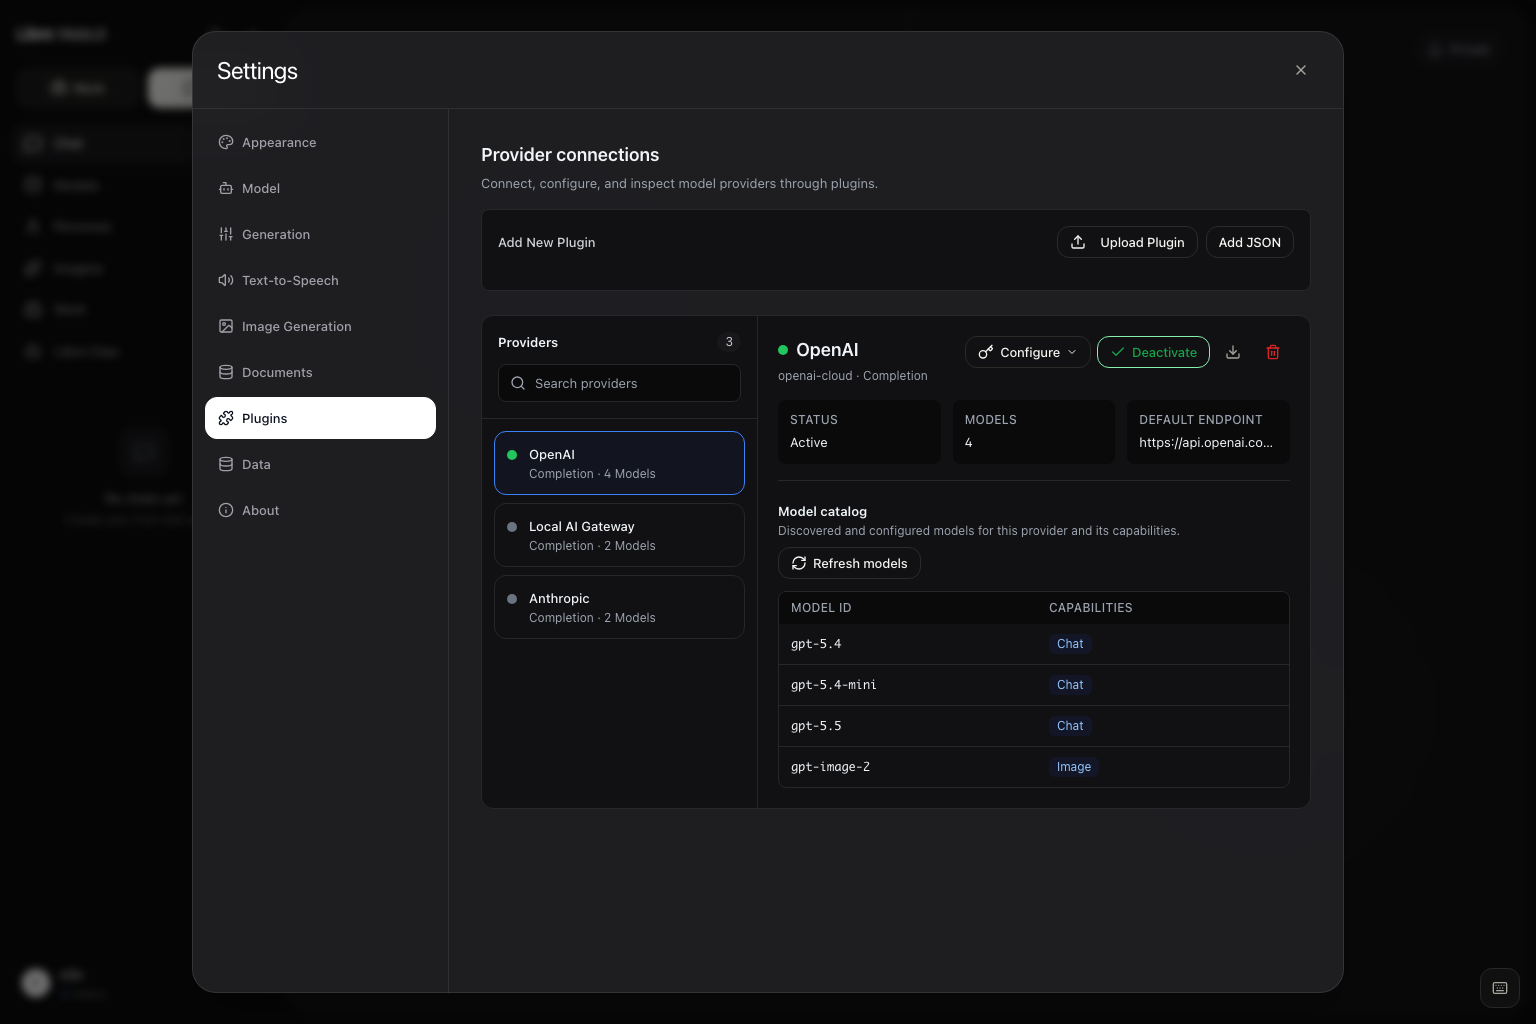
Libre WebUI 0.16.0 ergänzt unter Einstellungen > Plugins einen eigenen Arbeitsbereich Anbieter-Verbindungen. Aktiviere integrierte Anbieter, richte kompatible Plugins auf andere APIs, prüfe den effektiven Modellkatalog oder verbinde ein selbst gehostetes Gateway in einem vertrauenswürdigen Netzwerk.
Libre WebUI unterstützt derzeit diese Anbieterprotokolle:
- OpenAI Chat Completions;
- OpenAI Responses;
- Anthropic Messages; und
- Google Gemini-Inhalte und Funktionsaufrufe.
Die integrierten Anthropic- und Gemini-Definitionen nutzen eigene Adapter anhand ihrer Identität. Ein neu importierter Anbieter verwendet OpenAI Chat Completions oder Responses; eine Anthropic-/Gemini-kompatible URL wählt nicht automatisch deren Adapter. Andere Anfrage-, Streaming-, Werkzeug- oder Antwortformen benötigen einen Backend-Adapter. Plugin-JSON beschreibt Routing und Konfiguration, übersetzt aber kein fremdes Protokoll.
Anbieterverbindungen öffnen
- Melde dich an und öffne Einstellungen > Plugins.
- Durchsuche die Anbieterliste links.
- Wähle einen Anbieter und prüfe Aktivierung und effektiven Katalog.
- Aktiviere ihn für dein Konto.
- Öffne Konfigurieren nur für Anmeldedaten oder Verbindungsüberschreibungen.
Die Konfiguration ist standardmäßig geschlossen. Verbindungseinstellungen erscheinen für Administratoren zuerst; Sampling wie Temperatur und Tokenlimits bleibt unter Erweiterte Parameter getrennt eingeklappt. Geerbte Standards erscheinen als Hinweise, nicht als vorausgefüllte Kontoüberschreibungen.
Definitionen sind gemeinsame Instanzkonfiguration. Nur Administratoren können sie importieren, installieren, aktualisieren oder löschen. Jeder Benutzer kontrolliert eigene Aktivierung, Anmeldedaten und erlaubte Generierungseinstellungen.
Verbindung schnell hinzufügen
Einstellungen > Verbindungen ist der kurze Weg für einen OpenAI-kompatiblen Endpunkt mit API-Schlüssel. Administratoren sehen lokales Ollama mit Zustand und Version, vorhandene Verbindungen und ein Formular.
Erforderlich sind Anzeigename, vollständige Chat-Completions-URL und optionaler Schlüssel. Libre WebUI leitet die ID ab, installiert die Definition, speichert den Schlüssel serverseitig, aktiviert und fragt Modelle ab. Erkannte Modelle ersetzen den Platzhalterkatalog und erscheinen im Chat.
Jede Zeile zeigt Endpunkt, Modellzahl, Schlüsselstatus, Aktivierung, Aktualisierung und Löschen. Responses-Modi, Basis-URL, Kataloge je Fähigkeit und Parameterrichtlinien bleiben im vollständigen Plugin-Arbeitsbereich.
Codex (ChatGPT-Anmeldung)
Der integrierte Anbieter Codex (ChatGPT) braucht keinen API-Schlüssel. Bei einer
Codex CLI-Anmeldung des Servers (codex login als Betriebssystembenutzer) erscheint
er Administratoren und bietet GPT-6 Astra, GPT-6.1 Sol (gpt-6.1-sol), GPT-6.1 Terra (gpt-6.1-terra), GPT-6 Sol, GPT-6 Luna, GPT-5.6 Sol, Terra, Luna, GPT-5.5 und
GPT-5.3 Codex Spark über die ChatGPT-Sitzung, abhängig vom Modellzugriff des
angemeldeten Kontos. Tokens werden aus auth.json gelesen, mit demselben OAuth-Client erneuert
und zurückgeschrieben; Werte erscheinen nie in Protokollen.
Da Anfragen vom Backend statt aus Aufgabencontainern kommen, unterstützen die Modelle
auch Work mit normaler Sandbox-Schleife. Der Anbieter ist nur für Administratoren,
weil jeder Aufruf das ChatGPT-Abonnement des Servereigentümers nutzt. Blende ihn mit
CODEX_OAUTH_MODELS_ENABLED=false aus oder verwende über CODEX_HOME eine andere
Anmeldung.
Amazon Bedrock
Der integrierte Anbieter Amazon Bedrock nimmt einen Bedrock-API-Schlüssel
entgegen, entweder kurzzeitig oder langfristig, aus der Amazon-Bedrock-Konsole.
Speichere ihn in den Einstellungen des Anbieters oder setze
AWS_BEARER_TOKEN_BEDROCK auf dem Server. Es braucht kein AWS SDK, kein
Zugriffsschlüsselpaar und keine IAM-Signatur.
Libre WebUI spricht den Endpunkt bedrock-mantle.<region>.api.aws der Region an
und listet jedes Modell, das das Konto dort aufrufen kann, so wie OpenRouter
seinen Katalog listet. Modelle, die das Konto noch nicht nutzen kann, etwa wegen
seines Datenaufbewahrungsmodus, fehlen in der Liste. Wähle die Region mit der
Einstellung Region. Sie wechselt nur zwischen Bedrock-Hosts, sodass der
Schlüssel nie anderswohin gesendet werden kann, und eine Änderung behält den
gespeicherten Schlüssel.
Claude-Modelle (anthropic.*) laufen über die Anthropic Messages API von
Bedrock, daher verhalten sich Nachdenken, Tools und Token-Obergrenzen wie beim
Anbieter Anthropic. Alle anderen Modelle nutzen Chat Completions. Bedrock liefert
einige Familien über eine zweite Chat-Completions-Route; Libre WebUI probiert
diese Route, wenn Bedrock sagt, dass ein Modell dort liegt, und merkt sie sich.
Chat, Work und die Strands-Engine können alle diese Modelle nutzen, und die
Nutzung erscheint in den Analysen unter dem Anbieter.
In kommerziellen Regionen stellt AWS Claude Haiku 5.5 und Claude Sonnet 5.5 nur
über bedrock-runtime bereit, mit regionsübergreifenden Inferenzprofilen, daher
enthält die Modellliste von Mantle sie nie. Der Katalog ergänzt
global.anthropic.claude-haiku-5-5 und global.anthropic.claude-sonnet-5-5,
und jede Claude-Inferenzprofil-ID (global., us., eu., au. oder jp.)
wird mit demselben API-Schlüssel an
bedrock-runtime.<region>.amazonaws.com/anthropic/v1/messages der gewählten
Region gesendet. Der Schlüssel geht weiterhin nur an die zwei Bedrock-Hosts dieser
Region. Dein Konto braucht weiterhin Zugriff auf das Modell in Amazon Bedrock.
Modal
Der integrierte Anbieter Modal ruft den gemeinsam genutzten Inferenz-Router
von Modal, https://inference.us-west.modal.direct/v1, mit Chat Completions
auf. Er erreicht die Shared Endpoints in deinem Modal-Workspace, die Modal pro
Token abrechnet.
- Lege für jedes gewünschte Modell einen Shared Endpoint an, über den Tab
Endpoints im Modal-Dashboard oder mit
modal endpoint create --shared --model moonshotai/Kimi-K3. - Erstelle ein Proxy-Token in den Einstellungen des Modal-Dashboards oder mit
modal workspace proxy-tokens create. - Verbinde Token-ID und Secret mit einem Punkt,
wk-<id>.ws-<secret>, und speichere das Ergebnis als API-Schlüssel des Anbieters, oder setzeMODAL_PROXY_TOKENauf dem Server.
Libre WebUI listet dann jeden Endpunkt, den das Token über /v1/models des
Routers erreichen kann, mit seinem Kontextfenster und der Angabe, ob das Modell
nachdenkt. Der Router kennt ein Modell nur über den Hostnamen seines Endpunkts,
etwa acme--ep-muse-spark-open-816b-a42b-server.us-west.modal.direct; das ist
also die Modell-ID, die Libre WebUI sendet. Die Modellauswahl zeigt es unter dem
Namen des Endpunkts an, hier „Muse Spark Open 816B A42B“. Ein Modell ohne
Endpunkt in deinem Workspace antwortet mit unknown inference model.
Alle Anfragen einer Unterhaltung tragen denselben Modal-Routing-Affinity-Key,
abgeleitet aus dem Modell und der ersten Nachricht der Unterhaltung, damit Modal
sie an den Container leitet, der den Prompt der Unterhaltung bereits im Cache
hält. Work macht dasselbe für jeden Schritt der Agent-Schleife eines Laufs.
Zwischengespeicherte Eingabe-Tokens kosten einen Bruchteil des normalen Preises.
Wenn die Verdichtung den Verlauf neu schreibt, ändert sich der Schlüssel, wie
Modal es empfiehlt.
Um einen einzelnen Endpunkt direkt aufzurufen, setze die Einstellung
Vollständige API-Endpunkt-URL des Anbieters auf seine URL (modal endpoint info <name> zeigt
sie als service_url), gefolgt von /v1/chat/completions. So erreichst du
einen Dedicated Endpoint; dort behält das Modell seinen Hugging-Face-Namen, etwa
moonshotai/Kimi-K3, und so benennt auch die integrierte Liste die gemeinsam
genutzten Modelle von Modal, bevor ein Token gespeichert ist. Shared Endpoints
begrenzen gleichzeitige Anfragen pro Modell und antworten oberhalb des Limits
mit 429.
OpenCode in Work kann dasselbe Token nutzen. Ist MODAL_PROXY_TOKEN auf dem
Server gesetzt oder eine Modal-Anmeldung mit opencode auth login gespeichert,
läuft ein modal/…-Modell in der Sandbox, und das Token wird nur an
inference.us-west.modal.direct gesendet.
Baseten
Der integrierte Anbieter Baseten ruft die Model APIs von Baseten,
https://inference.baseten.co/v1, mit Chat Completions auf. Baseten hostet die
Modelle und rechnet pro Token ab, daher musst du vorher nichts bereitstellen.
- Erstelle im Baseten-Dashboard unter Settings > API keys einen persönlichen API-Schlüssel.
- Speichere ihn als API-Schlüssel des Anbieters oder setze
BASETEN_API_KEYauf dem Server.
Libre WebUI listet dann den Katalog der Model APIs aus /v1/models, mit dem
Kontextfenster jedes Modells und der Angabe, ob es nachdenkt. Die
Entscheidungsmodelle von Baseten (decision-models/…) beantworten nur die
System One API von Baseten und werden deshalb als Entscheidungsmodelle statt als
Chatmodelle gelistet; siehe Entscheidungsmodelle. Modelle
behalten die Slugs von Baseten, etwa zai-org/GLM-5.3 oder
moonshotai/Kimi-K3; die Auswahl zeigt sie als „GLM 5.3“ von Z.ai und
„Kimi K3“ von Moonshot AI. Eine Fast-Variante führt dieselben Gewichte auf
dedizierter Kapazität zu einem eigenen Preis aus.
Die meisten dieser Modelle denken standardmäßig nach. Die Nachdenken-Steuerung
im Chat setzt reasoning_effort von Baseten: Niedrig und Hoch werden
unverändert gesendet, die mittlere Einstellung belässt das Modell bei seiner
eigenen Standardtiefe, und Aus sendet none. Sehr hoch sendet high,
weil sich die Modelle von Baseten bei der Stufe darüber uneins sind: Manche
nehmen xhigh, manche nur max und manche keines von beiden. Baseten
dokumentiert einige Ausnahmen: Muse Spark Open und Beam denken immer nach, und
GLM 5.3 denkt auch mit none noch leicht nach. Früheres Nachdenken wird als
reasoning_content zurückgesendet, was Beam bei jeder früheren Antwort
verlangt.
Alle Anfragen einer Unterhaltung tragen denselben Schlüssel
x-session-affinity, abgeleitet aus dem Modell und der ersten Nachricht der
Unterhaltung, damit Baseten sie an das Replikat leitet, das den Prompt der
Unterhaltung bereits im Cache hält. Work macht dasselbe für jeden Schritt der
Agent-Schleife eines Laufs. Wenn die Verdichtung den Verlauf neu schreibt,
ändert sich der Schlüssel.
Um stattdessen ein dediziertes Deployment aufzurufen, setze die Einstellung
Vollständige API-Endpunkt-URL des Anbieters auf
https://model-<model id>.api.baseten.co/environments/production/sync/v1/chat/completions.
Derselbe API-Schlüssel funktioniert dort.
OpenCode in Work kann denselben Schlüssel nutzen. Ist BASETEN_API_KEY auf dem
Server gesetzt oder eine Baseten-Anmeldung mit opencode auth login
gespeichert, läuft ein baseten/…-Modell in der Sandbox, und der Schlüssel wird
nur an inference.baseten.co gesendet.
Integrierten oder importierten Anbieter wählen
Libre WebUI enthält Definitionen für OpenAI, Anthropic, Gemini, Groq, Mistral, DeepSeek, Meta, Modal, Baseten, Amazon Bedrock, OpenRouter, Kimi Code von Moonshot AI, Hugging Face, GitHub Models, lokales MLX LM und weitere Modell-/Mediendienste. Beginne mit einer integrierten Definition, wenn Protokoll und Authentifizierung passen.
Administratoren können für kompatible Dienste Plugin-JSON importieren. Minimalbeispiel:
{
  "id": "private-ai-gateway",
  "name": "Private AI Gateway",
  "type": "completion",
  "endpoint": "http://ai-gateway:8080/v1/chat/completions",
  "api_mode": "chat_completions",
  "auth": {
    "header": "Authorization",
    "prefix": "Bearer ",
    "key_env": "PRIVATE_AI_GATEWAY_API_KEY"
  },
  "model_map": ["gateway-chat"]
}
Importiere unter Einstellungen > Plugins, aktiviere und speichere den Schlüssel
für das verwendende Konto. Ergänze Verbindungsvariablen für bearbeitbare Basis-URL,
Pfad, Erkennung oder funktionsbezogene Endpunkte. Das integrierte
plugins/openai.json
ist ein vollständiges Beispiel.
Für ein bewusst authentifizierungsloses Gateway setze auth.header und
auth.key_env leer und lasse auth.prefix weg. Libre WebUI verlangt und sendet
dann keinen Schlüssel.
Chat Completions oder Responses
OpenAI-kompatible Plugins unterstützen beide Modi:
| API-Modus | Standardpfad | Typisches Feld |
|---|---|---|
chat_completions | /chat/completions | messages |
responses | /responses | input |
Der integrierte OpenAI-Anbieter zeigt API-Modus. Libre WebUI bildet fertige und gestreamte Responses-Ausgabe auf Chat und Work ab, einschließlich begrenztem Wiederholungszustand für Schlussfolgern und Werkzeuge.
Der Modus ändert den Standardpfad, nicht das Protokoll des Upstreams. Wähle Responses nur bei kompatiblen Anfrage- und Ereignisformen.
Basis-URL oder vollständigen Endpunkt konfigurieren
Die Vervollständigungsroute wird so aufgelöst:
- Nichtstandardmäßige vollständige
endpoint-Überschreibung. base_urlplus optionalesapi_path.- Endpunkt der Definition.
Basis-URL:
https://gateway.example/v1
Chat Completions ohne eigenen Pfad:
https://gateway.example/v1/chat/completions
Responses:
https://gateway.example/v1/responses
Nutze API-Pfad für eine andere relative Operation und Alter vollständiger Endpunkt nur für die komplette URL. Ein echter vollständiger Endpunkt hat Vorrang.
Bekannte Suffixe /chat/completions, /completions und /responses bestimmen
ebenfalls die Semantik. Unbekannte Pfade behalten den gewählten Modus.
Speichere nach Routen-/Schlüsseländerungen erneut. Eine benutzerdefinierte Route mit Authentifizierung braucht Anmeldedaten desselben Kontos. Ein bewusst offenes Plugin kann Felder leer lassen. Libre WebUI sendet keinen Betreiber-Umgebungsschlüssel an Benutzerziele; Umgebungsfallback gilt nur für die vertrauenswürdige integrierte Route.
Modell-IDs erkennen oder pflegen
Wähle einen aktiven Chat-Anbieter und Modelle aktualisieren. Libre WebUI lädt Anbieterkatalog und Chatliste neu.
Erkennung läuft automatisch, wenn der Katalog fehlt oder älter als
PLUGIN_MODEL_DISCOVERY_TTL_MS ist. Modelle aktualisieren erzwingt sofort:
| Ergebnis | Bedeutung |
|---|---|
| Katalog aktualisiert | Anbieter antwortete, Liste unterscheidet sich |
| Katalog bereits aktuell | Anbieter antwortete mit derselben Liste |
| API-Schlüssel erforderlich | Kein nutzbarer Schlüssel; keine Anfrage, alter Katalog bleibt |
| Katalog konnte nicht geladen werden | Anbieter unerreichbar oder ohne nutzbare Antwort |
Ein reiner Umgebungsschlüssel wird bei installierter statt integrierter Definition nicht verwendet; die Meldung weist darauf hin. Sprach-, Bild- und Embedding-Modelle werden mit Fähigkeiten gelistet, aber aus dem Chatwähler ausgeschlossen.
Für OpenAI-kompatible Routen gilt:
- Endung
/modelsbleibt unverändert; - bekannte Endungen
/chat/completions,/completions,/responses,/embeddingsoder/messageswerden durch/modelsersetzt; und - sonst wird
/modelsangehängt.
Beide Routen ergeben dieselbe Erkennungs-URL:
https://gateway.example/v1/chat/completions
https://gateway.example/v1/responses

-> https://gateway.example/v1/models
Falls die Ableitung falsch ist, exponiere models_endpoint im variables-Array:
{
  "name": "models_endpoint",
  "type": "string",
  "label": "Models Endpoint",
  "default": "https://gateway.example/v1/models"
}
Geerbter Standard oder Administratorwert hat Vorrang. Eine oberste
models_endpoint-Eigenschaft wird nicht gelesen. Erwartet wird ein OpenAI-
kompatibles data-Array:
{
  "data": [{ "id": "gateway-chat" }, { "id": "gateway-code" }]
}
Erkannte IDs werden je Benutzer gespeichert und schreiben das Plugin nicht um. Ohne
kompatible Erkennung pflege Ersatz-IDs in model_map. Der Katalog ist nur lesbar;
Fähigkeitslabels sind keine Zustandsprüfungen.
Modell-IDs sind nicht global eindeutig. Chat speichert Roh-ID mit exakter Ollama- oder Pluginidentität. Fällt der Anbieter weg, wird die Auswahl nicht verfügbar, statt still umgeleitet.
Bilderzeugung getrennt konfigurieren
Der OpenAI-Anbieter nutzt https://api.openai.com/v1/images/generations und setzt
bei neuen Konfigurationen gpt-image-2 als Standard. Ältere GPT Image-IDs bleiben.
Chat- und Bildrouten sind getrennt. Eine eigene Chat-Basis-URL erhält keine
Bildanfragen. Lasse image_endpoint leer für die Pluginroute oder setze die
vollständige kompatible Operation.
Bildauswahlen sind anbieterbezogen. Bei gleicher ID sendet Libre WebUI nur an den im Bildpanel gewählten Anbieter.
HTTP-Gateway sicher verbinden
Endpunkte dürfen absolute HTTP- oder HTTPS-URLs sein. HTTP eignet sich für vertrauenswürdige LAN-, Tailscale- oder Containernetze, überträgt Schlüssel, Prompts, Ergebnisse und Inhalt aber unverschlüsselt. Bevorzuge HTTPS über Netzwerkgrenzen.
Anfragen kommen vom Backend. Wähle eine erreichbare Adresse:
| Backend-Ort | Beispielwurzel |
|---|---|
| Nativer Prozess, gleicher Rechner | http://127.0.0.1:8081/v1 |
| Docker Compose-Dienst | http://ai-gateway:8080/v1 |
| Container zu unterstütztem Host | http://host.docker.internal:8081/v1 |
| Vertrauenswürdiges LAN/Tailscale | http://192.168.1.20:8081/v1 |
localhost im Container bezeichnet Libre WebUI selbst, nicht andere Dienste oder
automatisch den Host.
Libre WebUI akzeptiert nur HTTP/HTTPS, validiert das Endziel vor Anmeldedaten und folgt keinen Umleitungen. Konfiguriere die endgültige URL direkt.
Gateway vor Aktivierung prüfen
Teste Modellerkennung vom Backend-Rechner oder -Container:
curl http://ai-gateway:8080/v1/models \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY'
Teste danach die passende Operation.
Chat Completions:
curl http://ai-gateway:8080/v1/chat/completions \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "messages": [{"role": "user", "content": "Reply with: ready"}],
    "stream": false
  }'
Responses:
curl http://ai-gateway:8080/v1/responses \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "input": "Reply with: ready",
    "store": false
  }'
Konfiguriere nach Erfolg Route, Modus, Anmeldedaten und ID identisch. Aktiviere, aktualisiere Modelle und wähle das anbieterbezogene Modell. Work kann es bei zuverlässigen Werkzeugaufrufen ebenfalls nutzen.
Fehlerbehebung
| Symptom | Prüfung |
|---|---|
| Anfragen erreichen integrierten Endpunkt | Entferne veraltete vollständige Überschreibung und speichere Basis-URL/API-Pfad. |
| Anbieter erhält falsche Nutzlast | Stimme Modus mit Chat Completions oder Responses ab und prüfe Suffix. |
| Aktualisierung liefert keine IDs | Teste /models, data[].id, models_endpoint oder pflege model_map. |
| Altes Modell bleibt nach Routenänderung | Speichere; Libre WebUI löscht den veralteten erkannten Katalog. |
| API-Schlüssel fehlt | Speichere benutzerspezifische Anmeldedaten; integrierter Umgebungsfallback folgt Überschreibungen nicht. |
| Docker erreicht localhost nicht | Nutze Compose-Dienstnamen, Hostalias oder erreichbare private Adresse. |
| Chat funktioniert, Bilder nicht | Konfiguriere vollständigen image_endpoint separat und wähle ein Bildmodell. |
| Chat funktioniert, Work lehnt ab | Bestätige kompatible Werkzeugaufrufe; Textvervollständigung reicht nicht. |
| Anbieter leitet um | Konfiguriere endgültige validierte URL; Libre WebUI folgt Umleitungen nicht. |
Details zu Routing, Anmeldedaten, Wiedergabezustand und Autorisierung unter Plugins, Bereitstellungsfehler unter Fehlerbehebung.
Dank an die Gemeinschaft
Diese Anleitung und die Anbieterverbindungen in Libre WebUI 0.16.0 wurden durch ZhengJin (@fangzhengjin) geprägt. Detailliertes Feedback und das KI-gestützte UX-Konzept in #163 halfen beim Ablauf.