Conectar proveedores de terceros y autoalojados
Libre WebUI 0.16.0 añade un espacio específico de Conexiones de proveedores en Configuración > Plugins. Úsalo para activar un proveedor integrado, apuntar un plugin compatible a otra API, inspeccionar el catálogo efectivo o conectar una puerta autoalojada en una red de confianza.
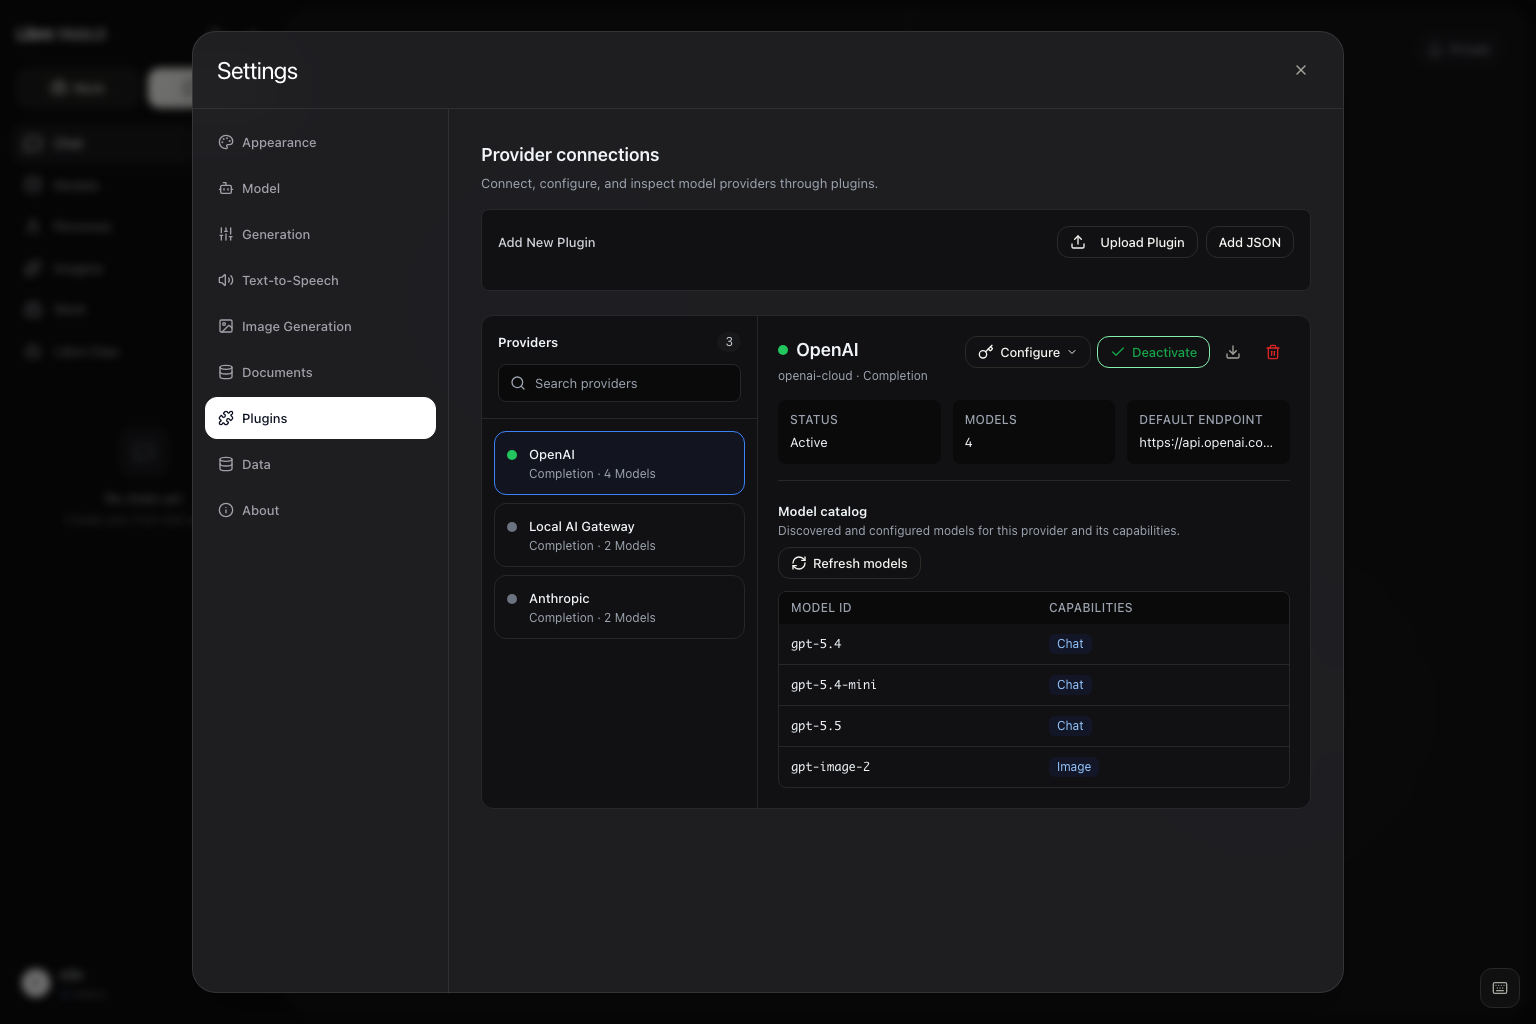
Libre WebUI admite actualmente estos formatos de comunicación:
- OpenAI Chat Completions;
- OpenAI Responses;
- Anthropic Messages; y
- contenidos y llamadas a funciones de Google Gemini.
Las definiciones integradas de Anthropic y Gemini usan adaptadores específicos seleccionados por sus identidades. Un proveedor recién importado usa semántica de OpenAI Chat Completions o Responses; apuntarlo a una API compatible con Anthropic o Gemini no selecciona esos adaptadores. Un proveedor con otra forma de solicitud, streaming, herramientas o respuesta necesita un adaptador del backend. El JSON describe enrutamiento y configuración; no traduce un protocolo ajeno.
Abrir Conexiones de proveedores
- Inicia sesión y abre Configuración > Plugins.
- Busca en la lista del panel izquierdo.
- Selecciona un proveedor para revisar su estado y catálogo efectivo.
- Actívalo para tu cuenta.
- Selecciona Configurar solo si necesitas guardar una credencial o sustituir un ajuste de conexión.
La configuración está cerrada por defecto. Los ajustes de conexión aparecen primero para administradores, mientras que los controles de muestreo, como temperatura y límites de tokens, permanecen en Parámetros avanzados, plegado por separado. Los valores heredados aparecen como sugerencias, no como sustituciones rellenadas.
Las definiciones son configuración compartida de la instancia, por lo que solo los administradores pueden importarlas, instalarlas, actualizarlas o eliminarlas. Cada usuario controla su activación, credencial y ajustes de generación permitidos.
Añadir una conexión rápidamente
Configuración > Conexiones es una ruta más corta para el caso habitual: un endpoint compatible con OpenAI y una clave de API. Los administradores ven una tarjeta del entorno Ollama local con salud y versión, las conexiones existentes y un pequeño formulario para añadir otra.
Se proporciona un nombre, la URL completa de completado de chat y una clave opcional. Libre WebUI deriva el ID del nombre, instala la definición, almacena la clave en el servidor, activa la conexión y pregunta al endpoint qué modelos ofrece. Los modelos descubiertos sustituyen al catálogo provisional y aparecen en Chat.
Cada fila muestra endpoint, número de modelos, si hay clave, activación, actualización y eliminación. Todo lo demás —modos Responses, URL base, catálogos por capacidad, política de parámetros— permanece en Configuración > Plugins.
Codex (inicio de sesión de ChatGPT)
El proveedor integrado Codex (ChatGPT) no requiere clave de API. Cuando el
servidor tiene una sesión de Codex CLI (codex login como usuario del sistema), el
proveedor aparece a los administradores y ofrece GPT-6 Astra, GPT-6.1 Sol (gpt-6.1-sol), GPT-6.1 Terra (gpt-6.1-terra), GPT-6 Sol, GPT-6 Luna, GPT-5.6 Sol, Terra,
Luna, GPT-5.5 y GPT-5.3 Codex Spark mediante la sesión de ChatGPT, según el acceso a
modelos de la cuenta conectada. Los tokens se leen del auth.json de la CLI, se
actualizan con su mismo cliente OAuth y se vuelven a escribir para que la CLI siga
funcionando; los valores nunca aparecen en registros.
Como las solicitudes proceden del backend, no de una tarea, estos modelos también
impulsan Work con el bucle aislado normal. Está restringido a administradores porque
cada llamada consume la suscripción de ChatGPT del propietario. Ocúltalo con
CODEX_OAUTH_MODELS_ENABLED=false o usa otra sesión mediante CODEX_HOME.
Amazon Bedrock
El proveedor integrado Amazon Bedrock acepta una clave de API de Bedrock, ya
sea de corta o de larga duración, obtenida en la consola de Amazon Bedrock.
Guárdala en los ajustes del proveedor o define AWS_BEARER_TOKEN_BEDROCK en el
servidor. No necesita SDK de AWS, par de claves de acceso ni firma IAM.
Libre WebUI se comunica con el endpoint bedrock-mantle.<region>.api.aws de la
región y lista todos los modelos que la cuenta puede invocar allí, igual que
OpenRouter lista su catálogo. Los modelos que la cuenta aún no puede usar, por
ejemplo por su modo de retención de datos, se omiten de la lista. Elige la
región con el ajuste Region. Solo cambia entre hosts de Bedrock, así que la
clave nunca puede enviarse a otro sitio, y cambiarlo conserva la clave guardada.
Los modelos Claude (anthropic.*) se ejecutan mediante la API Anthropic
Messages de Bedrock, por lo que el razonamiento, las herramientas y los límites
de tokens se comportan como con el proveedor Anthropic. Todos los demás modelos
usan Chat Completions. Bedrock sirve algunas familias en una segunda ruta de Chat
Completions; Libre WebUI prueba esa ruta cuando Bedrock indica que un modelo
está allí y la recuerda. Chat, Work y el motor Strands pueden usar estos modelos,
y el uso aparece bajo el proveedor en las analíticas.
En las Regiones comerciales, AWS sirve Claude Haiku 5.5 y Claude Sonnet 5.5 solo
en bedrock-runtime, mediante perfiles de inferencia entre Regiones, así que la
lista de modelos de Mantle nunca los incluye. El catálogo añade
global.anthropic.claude-haiku-5-5 y global.anthropic.claude-sonnet-5-5,
y cualquier ID de perfil de inferencia de Claude (global., us., eu., au. o jp.)
se envía con la misma clave de API a
bedrock-runtime.<region>.amazonaws.com/anthropic/v1/messages de la Región
seleccionada. La clave sigue yendo solo a los dos hosts de Bedrock de esa Región.
Tu cuenta sigue necesitando acceso al modelo en Amazon Bedrock.
Modal
El proveedor integrado Modal llama al router de inferencia compartido de
Modal, https://inference.us-west.modal.direct/v1, con Chat Completions. Llega
a los Shared Endpoints de tu espacio de trabajo de Modal, que Modal factura por
token.
- Crea un Shared Endpoint para cada modelo que quieras, desde la pestaña
Endpoints del panel de Modal o con
modal endpoint create --shared --model moonshotai/Kimi-K3. - Crea un token de proxy en los ajustes del panel de Modal o con
modal workspace proxy-tokens create. - Une el ID del token y el secreto con un punto,
wk-<id>.ws-<secret>, y guarda el resultado como clave de API del proveedor, o defineMODAL_PROXY_TOKENen el servidor.
Libre WebUI lista entonces todos los endpoints a los que llega el token según el
/v1/models del router, con su ventana de contexto y si razona. El router solo
conoce un modelo por el nombre de host de su endpoint, como
acme--ep-muse-spark-open-816b-a42b-server.us-west.modal.direct, así que ese es
el ID de modelo que envía Libre WebUI; el selector de modelos lo muestra con el
nombre del endpoint, aquí "Muse Spark Open 816B A42B". Un modelo sin endpoint en
tu espacio de trabajo responde unknown inference model.
Todas las solicitudes de una conversación llevan la misma clave
Modal-Routing-Affinity-Key, derivada del modelo y del primer mensaje de la
conversación, para que Modal las dirija al contenedor que ya tiene el prompt de
la conversación en su caché. Work hace lo mismo en cada paso del bucle de agente
de una ejecución. Los tokens de entrada en caché cuestan una fracción de la
tarifa normal. Cuando la compactación reescribe el historial, la clave cambia,
como recomienda Modal.
Para llamar directamente a un endpoint, define el ajuste URL completa del endpoint de API del
proveedor con su URL (modal endpoint info <name> la muestra como
service_url) seguida de /v1/chat/completions. Así se llega a un Dedicated
Endpoint; ahí el modelo conserva su nombre de Hugging Face, como
moonshotai/Kimi-K3, que es también como la lista integrada nombra los modelos
compartidos de Modal antes de guardar un token. Los Shared Endpoints limitan las
solicitudes simultáneas por modelo y responden 429 por encima del límite.
OpenCode en Work puede usar el mismo token. Con MODAL_PROXY_TOKEN definido en
el servidor, o un inicio de sesión de Modal guardado con opencode auth login,
un modelo modal/… se ejecuta en el sandbox, y el token solo se envía a
inference.us-west.modal.direct.
Baseten
El proveedor integrado Baseten llama a las Model APIs de Baseten,
https://inference.baseten.co/v1, con Chat Completions. Baseten aloja los
modelos y factura por token, así que no hay nada que desplegar primero.
- Crea una clave de API personal en el panel de Baseten, en Settings > API keys.
- Guárdala como clave de API del proveedor, o define
BASETEN_API_KEYen el servidor.
Libre WebUI lista entonces el catálogo de Model APIs desde /v1/models, con la
ventana de contexto de cada modelo y si razona. Los modelos de decisión de
Baseten (decision-models/…) solo responden a la System One API de Baseten, así
que se listan como modelos de decisión en lugar de modelos de chat; consulta
Modelos de decisión. Los modelos conservan los slugs de Baseten, como
zai-org/GLM-5.3 o moonshotai/Kimi-K3; el selector los muestra como "GLM 5.3"
de Z.ai y "Kimi K3" de Moonshot AI. Una variante Fast ejecuta los mismos
pesos en capacidad dedicada, con su propio precio.
La mayoría de estos modelos razonan por defecto. El control de razonamiento del
chat fija el reasoning_effort de Baseten: Bajo y Alto se envían tal
cual, el ajuste intermedio deja al modelo en su propia profundidad
predeterminada y Desactivado envía none. Muy alto envía high, porque
los modelos de Baseten no coinciden en el nivel superior: algunos aceptan
xhigh, otros solo max y otros ninguno de los dos. Baseten documenta algunas
excepciones: Muse Spark Open y Beam siempre razonan, y GLM 5.3 sigue razonando
ligeramente con none. El razonamiento anterior se devuelve como
reasoning_content, que Beam exige en cada respuesta anterior.
Todas las solicitudes de una conversación llevan la misma clave
x-session-affinity, derivada del modelo y del primer mensaje de la
conversación, para que Baseten las dirija a la réplica que ya tiene el prompt de
la conversación en su caché. Work hace lo mismo en cada paso del bucle de agente
de una ejecución. Cuando la compactación reescribe el historial, la clave
cambia.
Para llamar en su lugar a un despliegue dedicado, define el ajuste
URL completa del endpoint de API del proveedor como
https://model-<model id>.api.baseten.co/environments/production/sync/v1/chat/completions.
La misma clave de API funciona allí.
OpenCode en Work puede usar la misma clave. Con BASETEN_API_KEY definido en el
servidor, o un inicio de sesión de Baseten guardado con opencode auth login,
un modelo baseten/… se ejecuta en el sandbox, y la clave solo se envía a
inference.baseten.co.
Elegir un proveedor integrado o importado
Libre WebUI incluye definiciones para OpenAI, Anthropic, Gemini, Groq, Mistral, DeepSeek, Meta, Modal, Baseten, Amazon Bedrock, OpenRouter, Kimi Code de Moonshot AI, Hugging Face, GitHub Models, MLX LM local y otros servicios de modelos o medios. Empieza por una entrada integrada si su protocolo y autenticación coinciden con el servicio.
Para otro servicio compatible, un administrador puede importar una definición JSON. Este ejemplo mínimo describe una puerta compatible con OpenAI:
{
  "id": "private-ai-gateway",
  "name": "Private AI Gateway",
  "type": "completion",
  "endpoint": "http://ai-gateway:8080/v1/chat/completions",
  "api_mode": "chat_completions",
  "auth": {
    "header": "Authorization",
    "prefix": "Bearer ",
    "key_env": "PRIVATE_AI_GATEWAY_API_KEY"
  },
  "model_map": ["gateway-chat"]
}
Importa el archivo en Configuración > Plugins, actívalo y guarda la clave para
la cuenta que lo usará. Añade variables de conexión cuando los administradores
necesiten campos editables de URL base, ruta, exploración o endpoints por capacidad.
El archivo integrado
plugins/openai.json
es un ejemplo completo.
Para una puerta intencionadamente sin autenticación en una red de confianza, define
auth.header y auth.key_env como cadenas vacías y omite auth.prefix. Libre WebUI
no exigirá ni enviará una clave.
Elegir Chat Completions o Responses
Los plugins compatibles con OpenAI pueden usar ambos modos:
| Modo de API | Ruta predeterminada | Campo habitual |
|---|---|---|
chat_completions | /chat/completions | messages |
responses | /responses | input |
El proveedor integrado de OpenAI expone Modo de API. Libre WebUI adapta la salida de Responses, completa o en streaming, a Chat y Work, incluido estado de reproducción acotado para razonamiento y herramientas.
Cambiar el modo altera la ruta predeterminada, no el protocolo del servidor superior. Selecciona Responses solo si implementa formas compatibles de solicitudes y eventos.
Configurar una URL base o un endpoint completo
Libre WebUI resuelve la ruta de completado en este orden:
- Una sustitución completa de
endpointque no sea la predeterminada. base_urlmás unapi_pathopcional.- El endpoint declarado por la definición.
Usa URL base para la raíz:
https://gateway.example/v1
Sin ruta personalizada, Chat Completions envía a:
https://gateway.example/v1/chat/completions
Responses envía a:
https://gateway.example/v1/responses
Usa Ruta de API cuando el proveedor exponga una operación compatible en otra ruta relativa. Usa Endpoint completo heredado solo si necesitas aportar la URL completa; un endpoint genuino prevalece sobre URL base y Ruta de API.
Los sufijos conocidos /chat/completions, /completions y /responses también
identifican la semántica. Una ruta personalizada desconocida conserva el modo elegido.
Después de cambiar ruta o clave, vuelve a guardar antes de probar Chat. Si el plugin declara autenticación, una ruta personalizada exige una credencial guardada por la misma cuenta. Un plugin sin autenticación puede dejar ambos campos vacíos. Libre WebUI no envía una clave de entorno del operador a un destino del usuario; el respaldo de entorno se reserva a la ruta integrada de confianza.
Explorar o mantener ID de modelos
Selecciona un proveedor activo y pulsa Actualizar modelos. Libre WebUI recarga su catálogo y la lista de Chat.
La exploración también se ejecuta automáticamente: el catálogo se vuelve a descubrir
si falta o supera PLUGIN_MODEL_DISCOVERY_TTL_MS, de modo que los modelos siguen al
proveedor y no al momento de activación. Actualizar modelos fuerza la comprobación:
| Resultado | Significado |
|---|---|
| Catálogo actualizado | El proveedor respondió y la lista cambió |
| Catálogo ya actualizado | Respondió con la misma lista |
| Se necesita clave de API | No hay clave válida; no se hizo solicitud y se conserva el catálogo anterior |
| No se pudo cargar el catálogo | El proveedor no respondió o no devolvió nada utilizable |
Una clave solo de entorno no se usa para una definición instalada en vez de la integrada; el mensaje lo indica. Los modelos de voz, imagen y embeddings aparecen con etiquetas de capacidad, pero se excluyen del selector de chat.
Para una ruta compatible con OpenAI, la URL de modelos se elige así:
- una ruta terminada en
/modelsse usa tal cual; - un sufijo conocido como
/chat/completions,/completions,/responses,/embeddingso/messagesse sustituye por/models; y - en los demás casos se añade
/models.
Estas rutas derivan la misma URL:
https://gateway.example/v1/chat/completions
https://gateway.example/v1/responses

-> https://gateway.example/v1/models
Cuando la derivación no sea correcta, expón models_endpoint en el array variables:
{
  "name": "models_endpoint",
  "type": "string",
  "label": "Models Endpoint",
  "default": "https://gateway.example/v1/models"
}
El valor heredado o guardado por el administrador prevalece. No se lee una propiedad
models_endpoint de nivel superior. Se espera una respuesta compatible con OpenAI
con objetos en un array data:
{
  "data": [{ "id": "gateway-chat" }, { "id": "gateway-code" }]
}
Los ID se almacenan por usuario y no reescriben el archivo compartido. Si el
proveedor no implementa exploración compatible, mantén ID de respaldo en model_map.
El catálogo es de solo lectura; las etiquetas indican qué ruta enumera un modelo, no
son comprobaciones de salud.
Los ID no son globalmente únicos. Chat guarda el ID bruto con la identidad exacta de Ollama o plugin, por lo que varios proveedores pueden exponer el mismo nombre. Si el proveedor deja de estar disponible, Libre WebUI muestra la selección como no disponible en vez de redirigir silenciosamente.
Configurar la generación de imágenes por separado
El proveedor integrado de OpenAI expone imágenes mediante
https://api.openai.com/v1/images/generations y usa actualmente gpt-image-2 de
forma predeterminada en configuraciones nuevas. Los ID antiguos de GPT Image siguen
en el catálogo de respaldo.
Las rutas de Chat e imágenes están aisladas. Una URL base personalizada de Chat no
recibe solicitudes de imágenes automáticamente. Deja image_endpoint vacío para
usar el declarado por el plugin o define la URL completa de la operación compatible.
Las opciones de imagen se identifican por proveedor. Si dos plugins exponen el mismo ID, Libre WebUI solo envía al seleccionado en el panel de imágenes.
Conectar una puerta HTTP con seguridad
Los endpoints pueden ser URL absolutas HTTP o HTTPS. HTTP resulta útil en una LAN, red Tailscale o red de contenedores privada, pero envía claves, prompts, resultados y contenido sin cifrado de transporte. Prefiere HTTPS al cruzar un límite de red o si la puerta admite TLS.
Las solicitudes proceden del backend, no del navegador. Elige una dirección accesible:
| Ubicación del backend | Ejemplo de raíz |
|---|---|
| Proceso nativo, misma máquina | http://127.0.0.1:8081/v1 |
| Servicio Docker Compose | http://ai-gateway:8080/v1 |
| Contenedor al host compatible | http://host.docker.internal:8081/v1 |
| Host de LAN o Tailscale de confianza | http://192.168.1.20:8081/v1 |
Dentro de un contenedor, localhost identifica el propio contenedor de Libre WebUI,
no otro servicio Compose ni el host.
Libre WebUI solo acepta HTTP y HTTPS, valida el destino final antes de elegir una credencial y no sigue redirecciones para solicitudes de proveedor o exploración. Configura directamente la URL final.
Verificar la puerta antes de activarla
Prueba la exploración desde la máquina o contenedor que ejecuta el backend:
curl http://ai-gateway:8080/v1/models \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY'
Después prueba la operación del modo seleccionado.
Chat Completions:
curl http://ai-gateway:8080/v1/chat/completions \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "messages": [{"role": "user", "content": "Reply with: ready"}],
    "stream": false
  }'
Responses:
curl http://ai-gateway:8080/v1/responses \
  -H 'Authorization: Bearer YOUR_GATEWAY_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gateway-chat",
    "input": "Reply with: ready",
    "store": false
  }'
Cuando ambas funcionen, configura la misma ruta, modo, credencial e ID en Conexiones de proveedores. Activa, selecciona Actualizar modelos y elige el modelo identificado por proveedor en Chat. Work también puede usarlo si admite herramientas de forma fiable.
Solución de problemas
| Síntoma | Comprobación |
|---|---|
| Las solicitudes aún llegan al endpoint integrado | Elimina una sustitución completa obsoleta y guarda la URL base y Ruta de API deseadas. |
| El proveedor recibe una carga incorrecta | Haz coincidir Modo de API con Chat Completions o Responses y verifica el sufijo final. |
| Actualizar modelos no devuelve ID | Prueba /models, verifica data[].id, expón/configura models_endpoint o mantén model_map. |
| Permanece un modelo tras editar la ruta | Guarda el cambio; Libre WebUI borra el catálogo descubierto obsoleto antes de actualizar. |
| Se informa de que falta la clave | Guarda una credencial por usuario; el respaldo de entorno integrado no sigue sustituciones. |
| Docker no puede alcanzar localhost | Usa el nombre del servicio Compose, un alias de host compatible o una dirección privada accesible. |
| Chat funciona, pero no las imágenes | Configura image_endpoint completo por separado y selecciona un modelo de esa capacidad. |
| Chat funciona, pero Work rechaza el modelo | Confirma llamadas a herramientas compatibles; un completado de texto normal no basta. |
| El proveedor devuelve una redirección | Configura directamente la URL final validada; Libre WebUI no sigue redirecciones. |
Para detalles de enrutamiento, credenciales, estado de reproducción y autorización, lee Plugins. Para fallos de despliegue, consulta Solución de problemas.
Agradecimiento a la comunidad
Esta guía y la experiencia de Conexiones de proveedores de Libre WebUI 0.16.0 se beneficiaron de ZhengJin (@fangzhengjin), cuyos comentarios detallados y concepto de UX asistido por IA en #163 ayudaron a definir el flujo.